Silicon
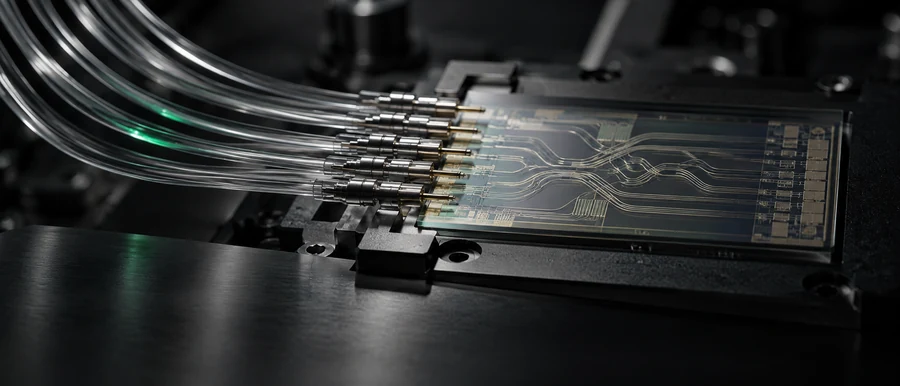
PsiQuantum mise sur la lumière pour reconnecter les GPU
PsiQuantum présente un commutateur optique issu de sa plateforme quantique. Son intérêt dépendra du passage à l’échelle et du logiciel qui choisit les connexions utiles.
GPU & Silicium
GPU, mémoire HBM, interconnexions NVLink et microarchitecture : ce qui détermine vraiment la performance et le coût du compute IA, du die au datacenter.
25 articles , page 1 sur 3
Silicon
PsiQuantum présente un commutateur optique issu de sa plateforme quantique. Son intérêt dépendra du passage à l’échelle et du logiciel qui choisit les connexions utiles.
Silicon
AMD conteste NVIDIA Vera avec EPYC Venice. Les agents attendent aussi leurs outils : pourquoi les scores par cœur et par rack ne racontent pas la même chose.
Silicon
Huawei présente Atlas 960E et ses 4 096 accélérateurs annoncés. Peut-on déplacer la compétition de la puce vers le système entier ?
Silicon
Une baie de GPU tire déjà plus de 2 000 ampères. À 1 MW, le 54 V actuel demande près de 20 000 ampères : voici pourquoi NVIDIA et les hyperscalers passent au 800 V continu, et ce qui reste à résoudre.
Silicon
Votre modèle dépasse la mémoire d’un GPU. AMD et NVIDIA proposent deux façons de lui faire de la place, mais leur capacité totale ne suffit pas à choisir.
Silicon
Ryzen AI Halo et DGX Spark proposent 128 Go, mais leurs performances changent selon le modèle et le protocole. Mesures constructeur et essais indépendants audités.
Silicon
BlueField-4 et Pensando Salina ne calculent aucun token. Ils déplacent le réseau, le stockage, la sécurité et certains transferts du KV cache hors du CPU hôte. Voici le chemin de données qui peut libérer le GPU, ou seulement déplacer le goulot.
Silicon
UALink 2.0 standardise le calcul dans le réseau ; NVLink 6 l'intègre dans ses switches. Voici ce que ce mécanisme change, et pourquoi Helios et Vera Rubin restent impossibles à départager.
Silicon
Évaluer un M3 Ultra 96 Go pour les LLM locaux : 819 Go/s, poids, contexte et MLX. Avec la distinction entre le catalogue M3 historique et les M5 actuels.
Silicon
Une RTX PRO 6000 et trois RTX 5090 totalisent chacune 96 Go de GDDR7. Pour un LLM, cette égalité s'arrête au nombre : pool unique, modèle réparti et répliques indépendantes ne paient pas les mêmes coûts.
Silicon
RTX Spark apporte jusqu'à 128 Go de mémoire unifiée et CUDA natif à Windows on Arm. Au 12 août, le pilote et CUDA 13.4 restent en Developer Preview, TensorRT-RTX est prêt, tandis que PyTorch, llama.cpp et la pile de serving sont encore à qualifier.
Silicon
Le MI455X embarque 432 Go de HBM4, contre 288 Go pour Rubin. Mais AMD doit aussi prouver que son tissu UALoE transforme cet avantage de capacité en performances au niveau du rack.