À la une
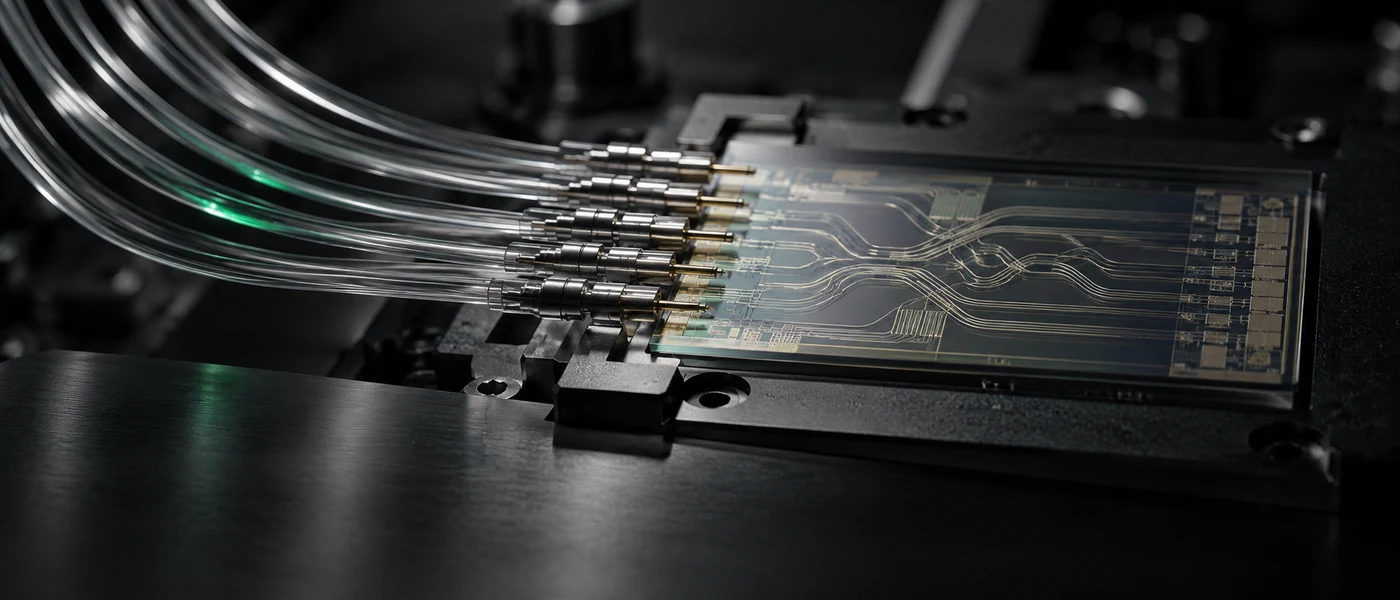
PsiQuantum mise sur la lumière pour reconnecter les GPU
PsiQuantum présente un commutateur optique issu de sa plateforme quantique. Son intérêt dépendra du passage à l’échelle et du logiciel qui choisit les connexions utiles.
À la une
PsiQuantum présente un commutateur optique issu de sa plateforme quantique. Son intérêt dépendra du passage à l’échelle et du logiciel qui choisit les connexions utiles.
LeCompute décortique l'infrastructure de l'IA : GPU et silicium, mémoire HBM et interconnexions, runtimes d'inférence comme vLLM ou llama.cpp, quantification et edge AI. Des analyses techniques et des benchmarks reproductibles, du silicium au code, sans hype.
Read our articles in EnglishCoûts
Un satellite de Google a renvoyé une réponse de Gemma 4. Derrière le haïku, Suncatcher met à l’épreuve le refroidissement, l’énergie et les communications du calcul spatial.
Runtimes
DeepSeek publie son moteur d’inférence. Le code révèle comment accélérer les modèles, mais aussi ce qu’il reste à assembler pour reproduire un service et ses coûts.
Kernel & Perf
Un travail peut ralentir sans qu’un GPU tombe en panne. Minerva relie les signaux des machines, du réseau et des tâches pour aider à retrouver l’origine de ces pertes de performance.
Edge AI
LFM3 face aux petits Qwen sur téléphone : mesures iPhone, mémoire réelle, qualité des réponses et intégration dans une application iOS, Android ou embarquée.
Kernel & Perf
Un GPU peut exécuter du code sans exploiter toutes ses ressources. De ThunderKittens à Flapping Airplanes, comprendre le travail que les mégakernels cherchent à faire se chevaucher.
Kernel & Perf
Un agent termine sa modification, puis attend que les tests récupèrent le code. Le cas Scion permet de comprendre ce coût caché et les choix d’infrastructure pour le réduire.