Les GPU sont présents, le travail avance moins vite
Un entraînement prenait une durée prévisible par étape. Depuis ce matin, certaines étapes s’allongent. Les processus sont toujours là, les GPU restent visibles et aucune machine n’a complètement disparu. Redémarrer le travail peut faire disparaître le symptôme sans expliquer son origine.
Le ralentissement peut venir du calcul, d’une donnée qui arrive trop tard, d’un échange réseau ou d’un seul participant qui retarde les autres. Un compteur GPU ne suffit pas à départager ces possibilités. Il faut reconstruire ce que faisait le travail au moment où sa progression a changé.
NVIDIA a présenté Minerva le 22 octobre 2026 comme une plateforme d’AIOps, une aide aux opérations fondée sur l’analyse automatisée des données d’exploitation. L’entreprise annonce une mise en relation de la télémétrie d’infrastructure et des charges IA pour détecter les anomalies et faciliter le diagnostic.
Ce dossier confronte l’annonce à la documentation publique 1.0.1, consultée au 1er novembre 2026. Les cas d’usage sont rapportés par NVIDIA. LeCompute n’a pas installé Minerva sur un cluster de production et ne présente pas de mesures indépendantes de ses gains.
À quoi ressemble Minerva pour l’opérateur ?
L’opérateur consulte Minerva dans une interface web. La présentation du guide 1.0.1 décrit des onglets pour les tableaux de bord, la topologie, les anomalies, les incidents et les tendances, ainsi qu’un assistant nommé Sherlock. Le tableau de bord ci-dessous rassemble des indicateurs et des journaux sur un même écran.
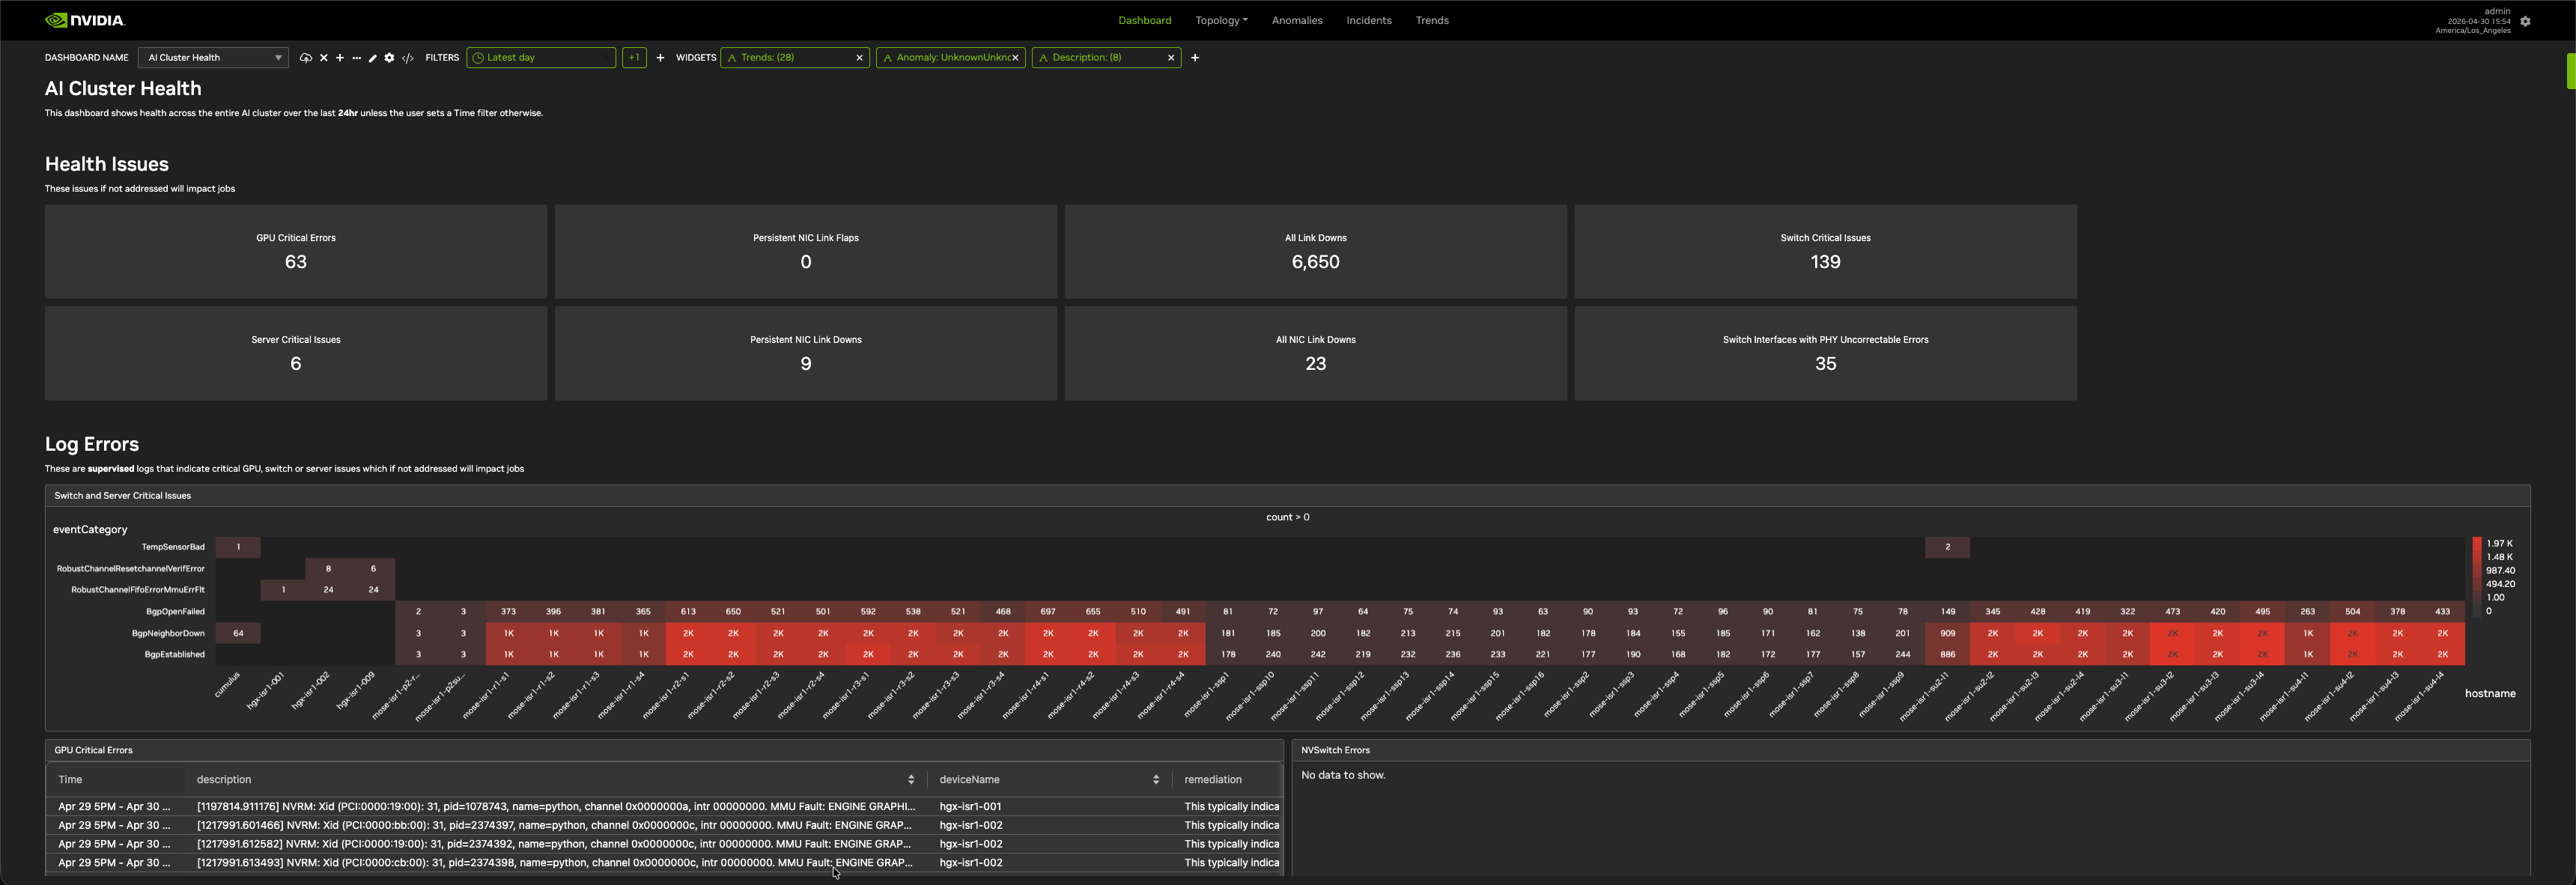
Regardez d’abord les catégories affichées : erreurs GPU, interfaces réseau, commutateurs et serveurs. L’outil donne à l’équipe d’exploitation un point de départ commun pour son enquête. Dans notre scénario d’entraînement ralenti, elle doit ensuite retrouver le travail concerné et les équipements qu’il utilise. La vue Topology permet ce passage vers une carte du réseau filtrée par identifiant de travail, comme dans le cas documenté plus bas. Les valeurs de cette capture appartiennent à l’exemple de NVIDIA ; elles ne décrivent pas un cluster de LeCompute.
Ce qu’un pourcentage d’utilisation GPU laisse de côté
La définition précise d’une métrique compte. Dans la documentation nvidia-smi, l’utilisation GPU désigne la proportion de la période d’échantillonnage pendant laquelle au moins un kernel s’exécute. Un kernel est une fonction lancée sur le GPU. Cette définition ne mesure pas la fraction de toute sa puissance de calcul transformée en résultats utiles.
Un programme peut exécuter des kernels pendant que certaines ressources attendent des données. Il peut aussi refaire des calculs après une erreur ou consacrer du temps à une synchronisation. L’activité et la progression de l’application doivent donc être observées ensemble.
À l’échelle du service, commencez par définir le résultat attendu. Pour un entraînement, cela peut être le temps nécessaire pour atteindre une qualité donnée. Pour l’inférence, cela peut être le nombre de requêtes correctes terminées dans le délai demandé. Ces objectifs donnent un sens aux métriques matérielles.
Le terme goodput désigne ici un débit utile, compté selon les critères du service. Dans un exemple hypothétique, un serveur termine 100 requêtes en 10 secondes, mais seulement 80 respectent le délai imposé. Son débit brut vaut 10 requêtes par seconde ; son débit utile selon ce critère vaut 8. Ce calcul n’est pas une mesure de Minerva : il explique pourquoi davantage d’activité ne suffit pas à établir un meilleur service.
Relier les données aux machines et aux tâches
La télémétrie rassemble des mesures et événements : température, erreurs d’une interface réseau, début d’un travail ou changement de débit. Pour les utiliser ensemble, il faut savoir quel équipement les a produits et quelles tâches en dépendaient à cet instant.
Le modèle réseau de Minerva organise les objets de l’infrastructure et leurs relations. Cette topologie est plus qu’un dessin de connexions. Elle donne le contexte nécessaire pour chercher quels travaux peuvent être touchés par une anomalie sur un lien ou un équipement partagé.
Imaginons qu’un même commutateur participe au trajet de plusieurs machines. Un problème sur ce commutateur peut provoquer des symptômes sur chacune d’elles. Regarder seulement les hôtes fait apparaître plusieurs incidents ; regarder leur dépendance commune fournit une hypothèse plus ciblée.
Cette hypothèse demande encore une vérification. Des événements proches dans le temps peuvent avoir plusieurs causes. La chronologie, les compteurs et le retour à la normale après une intervention servent à tester l’explication proposée. Une corrélation aide à enquêter ; elle ne constitue pas, à elle seule, une preuve de causalité.
Ce qui se passe entre la collecte et l’alerte
La description d’architecture sépare la collecte d’une plateforme qui modélise les objets, enrichit les données, applique des analyses et conserve les résultats. Le collecteur doit avoir accès au réseau observé. Cette séparation permet de comprendre où les données entrent et où elles sont interprétées.
La qualité de ces étapes dépend de l’instrumentation. Un identifiant de tâche absent, une horloge décalée ou une interface mal associée compliquent le rapprochement. Un système d’analyse ne peut pas reconstituer avec certitude une relation qui n’est ni collectée ni correctement modélisée.
Pour cette raison, installer un outil d’AIOps commence aussi par un travail de données. Les équipes doivent vérifier les identifiants stables, les intervalles de collecte, la conservation des historiques et la couverture des équipements. Un tableau de bord rempli ne garantit pas que ces préalables sont satisfaits.
Comment le réseau peut retarder tous les participants
Dans un entraînement distribué, plusieurs accélérateurs échangent des résultats. Une opération collective, comme un all-reduce, agrège des contributions et redistribue le résultat aux participants. Si un échange nécessaire attend un participant ou un trajet réseau, la suite du travail peut attendre aussi.
La documentation Minerva sur les retransmissions RoCE montre une enquête filtrée par identifiant de travail. Elle rapproche des anomalies réseau des échanges NCCL, la bibliothèque de communication collective de NVIDIA. Le diagnostic consiste à retrouver les équipements qui participaient au travail affecté, puis à examiner leurs signaux.
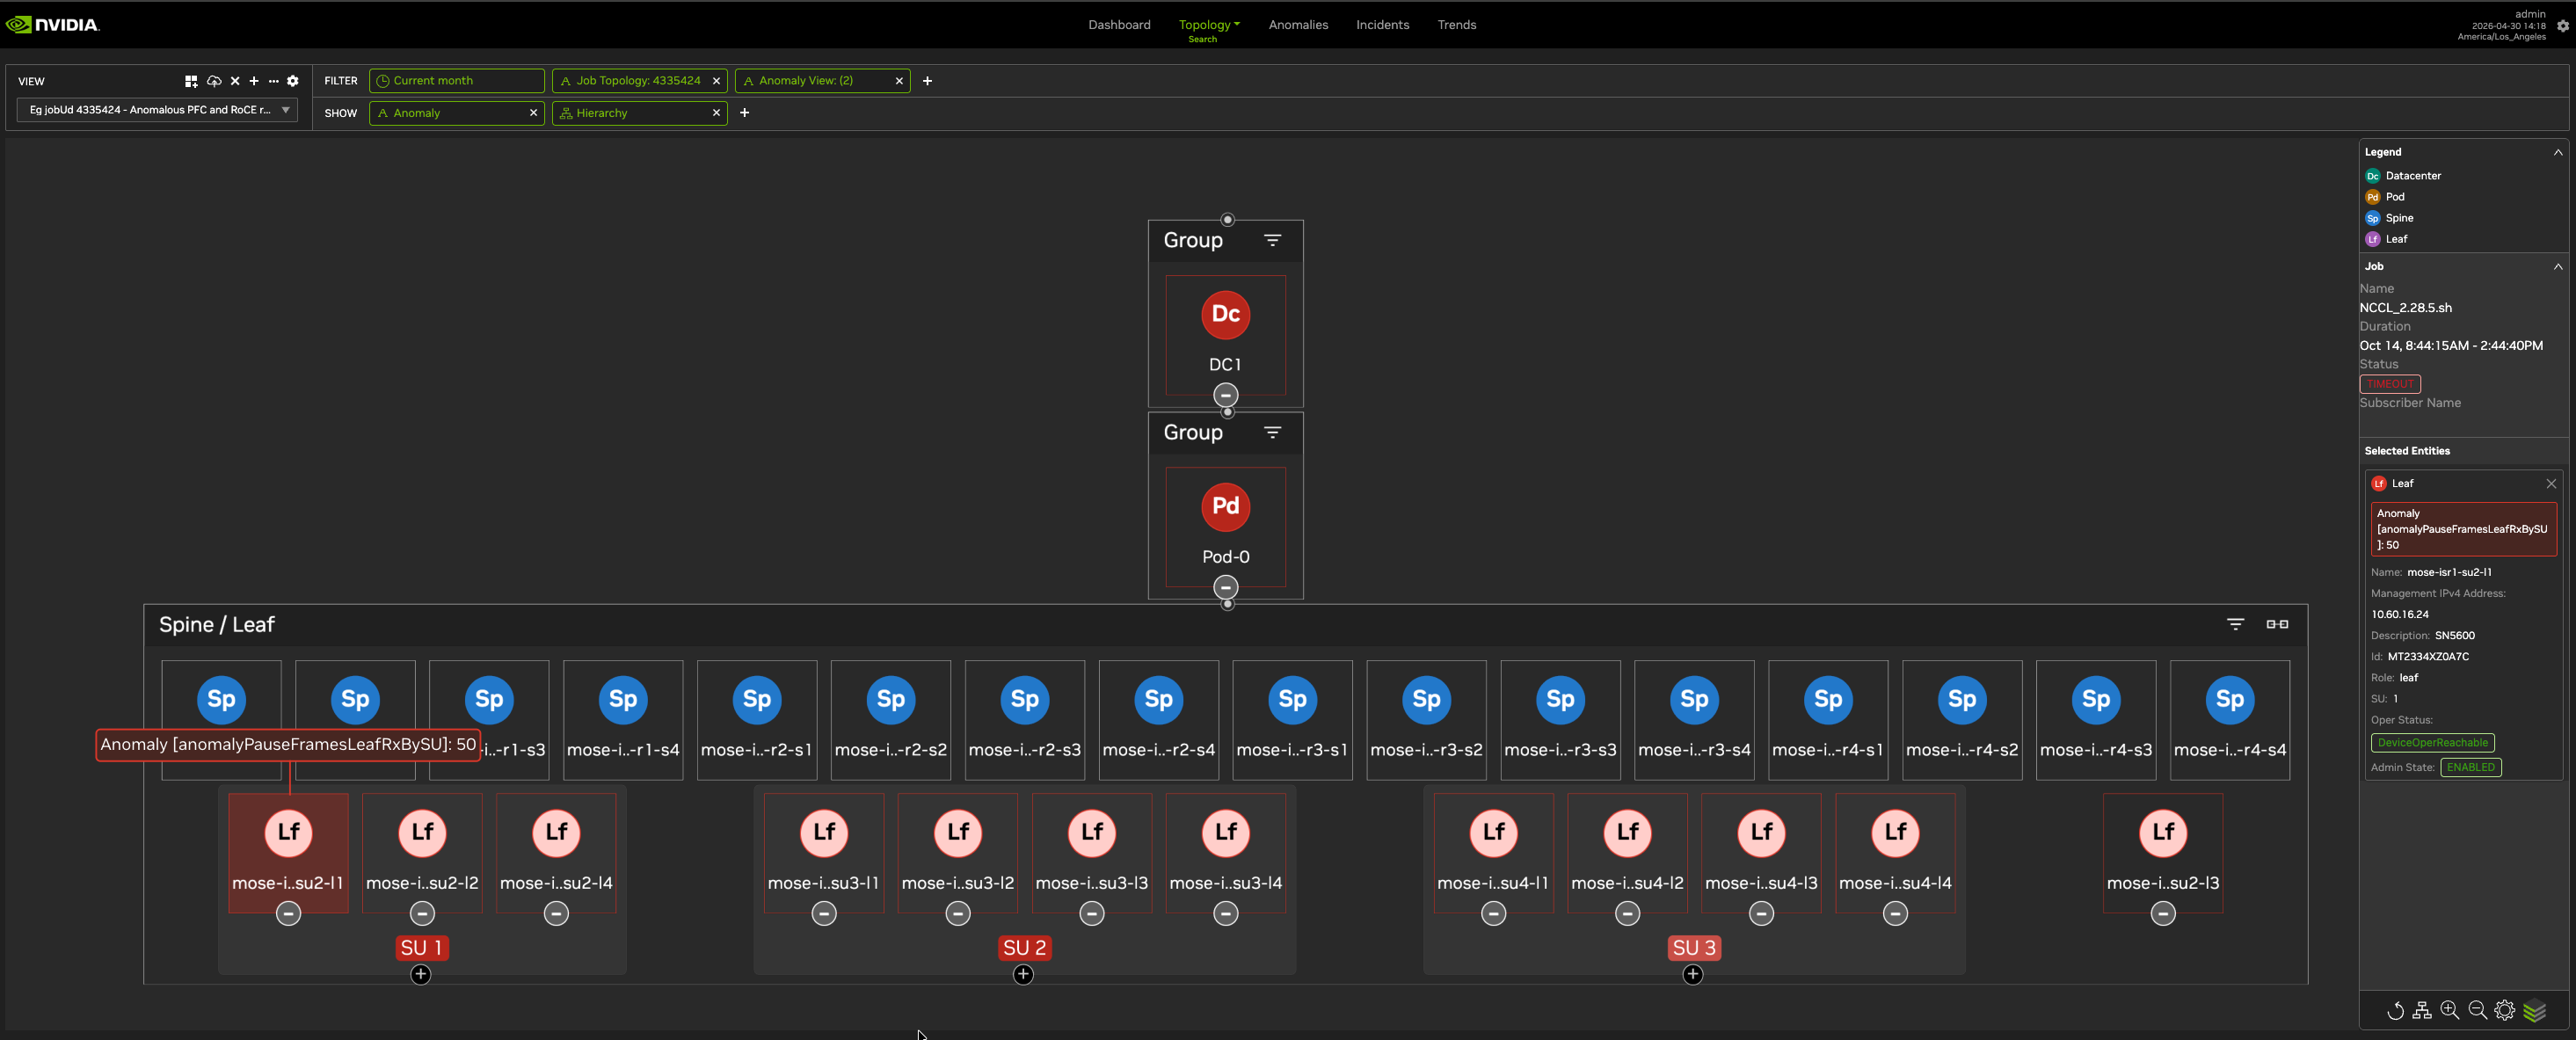
Pour lire cette carte, partez du filtre Job Topology: 4335424 en haut. Les groupes Spine / Leaf représentent les couches de commutateurs du réseau. Les zones signalées et le panneau de droite aident à choisir quels équipements et quelles anomalies examiner. L’opérateur passe ainsi de « mon entraînement ralentit » à une enquête sur les dépendances réseau de ce travail, sans devoir inspecter toutes les machines du cluster une par une.
Il reste à distinguer les symptômes. Une baisse de débit de l’application est une conséquence observée. Des retransmissions indiquent qu’un échange doit être répété. Des signaux de contrôle de flux renseignent sur le comportement du réseau. Leur présence ensemble aide à orienter l’enquête, mais ne justifie pas de remplacer arbitrairement un GPU.
Le même raisonnement vaut pour d’autres dépendances. Si les données d’entrée arrivent trop lentement, accélérer une multiplication de matrices ne rétablit pas leur arrivée. Si un processus est retardé côté CPU, l’absence de progrès visible sur le GPU peut avoir commencé ailleurs.
Regrouper les alertes sans supprimer les preuves
Un incident partagé peut déclencher une alerte sur de nombreux composants. Les opérateurs doivent alors retrouver quelles alertes décrivent le même événement et lesquelles révèlent un second problème.
La configuration d’auto-corrélation propose un regroupement par métadonnées communes, comme un rack ou un jobId, ou par relations topologiques. Le choix du regroupement appartient donc au fonctionnement concret du produit ; il ne repose pas uniquement sur une conversation avec un assistant.
NVIDIA publie un cas de corrélation de pause frames où 81 anomalies sont regroupées en un incident. Ce nombre illustre une consolidation rapportée par le fournisseur. Il ne mesure ni un taux de détection valable partout, ni la fréquence des fausses alertes sur votre infrastructure.
Un regroupement utile conserve les éléments qui permettent de contrôler son résultat : équipements concernés, fenêtre temporelle, événements d’origine et règle ou contexte de rapprochement. Sans ces éléments, l’opérateur gagne une alerte plus courte mais perd la possibilité de contester le diagnostic.
Une évaluation doit aussi regarder ce que le système manque. Diminuer le nombre de notifications est facile si l’on rend les seuils moins sensibles. Le bénéfice apparaît lorsque les incidents pertinents restent détectés et deviennent plus rapides à comprendre.
Sherlock aide à interroger ; le MCP documenté reste en lecture seule
La page produit présente Sherlock, un assistant qui aide à explorer les données en langage naturel. Une question comme « quels liens montrent des erreurs pendant ce travail ? » peut servir de point d’entrée, à condition de pouvoir examiner les données et la requête qui soutiennent la réponse.
Le MCP, ou Model Context Protocol, fournit une interface permettant à un assistant externe de découvrir et d’appeler des outils. La documentation du connecteur Minerva 1.0.1 décrit un accès authentifié en lecture seule, en bêta. Il expose des requêtes de données et de topologie ; il ne répare pas les incidents et ne modifie pas la configuration.
Cela fixe une limite concrète aux promesses d’automatisation. Interroger, recommander et agir sont trois capacités distinctes. Une action effectuée par un autre outil ou une intégration d’exploitation doit être évaluée avec ses propres permissions, sa validation et son retour en arrière.
La documentation MCP indique aussi que cet accès n’est pas isolé par tenant : un utilisateur autorisé peut lire les données du déploiement. Un filtre de cluster ou de namespace dans une requête ne constitue pas une autorisation par utilisateur. Le périmètre de connexion doit tenir compte de cette portée.
Les notes 1.0.1 limitent certaines promesses de déploiement
La communication produit présente plusieurs modes, dont le SaaS. Pourtant, les notes de version 1.0.1 indiquent que les déploiements cloud/SaaS ne sont pas pris en charge. À cette date, il faut donc vérifier la version et l’offre effectivement accessibles, plutôt que déduire une disponibilité de la page générale.
Ces notes signalent également que les API sous /minerva/api sont sans authentification par défaut et demandent la configuration d’une clé avant exposition à un réseau non fiable. Elles documentent des limites d’isolation des données entre tenants. Ce sont des conditions de déploiement propres à cette version, à traiter avant une intégration à des données d’exploitation sensibles.
Ces réserves ne décrivent pas toutes les éditions futures du produit. Elles montrent pourquoi un article technique doit consulter les notes de version en plus de l’annonce : les capacités, les limites et les valeurs par défaut ne se lisent pas au même endroit.
Ce que Minerva ajoute à DCGM, Prometheus et Grafana
DCGM Exporter expose des métriques GPU à un point d’accès utilisable par des systèmes comme Prometheus. Cette collecte sert déjà à construire une observation des GPU. Une équipe peut ensuite rapprocher elle-même ces données de celles du service et du réseau.
La proposition de Minerva consiste à fournir davantage de contexte et d’analyse entre ces signaux. La documentation décrit aussi un export vers un Prometheus externe. L’évaluation peut donc porter sur son apport à une pile existante, plutôt que supposer que tous les outils doivent être remplacés.
La question utile devient : quelles enquêtes restent longues avec votre installation actuelle ? Si vous passez du temps à relier manuellement des identifiants et des équipements, la corrélation peut être pertinente. Si la limite vient d’un kernel spécifique dans une application unique, un profileur local et une analyse système peuvent rester plus directs. Notre dossier eBPF et perf pour l’inférence couvre cette autre échelle.
La portée matérielle compte aussi. Le produit est présenté autour de la pile NVIDIA. Une prise en charge générale de chaque composant d’un parc hétérogène doit être confirmée, avec la profondeur des métriques obtenues. Une vue commune ne garantit pas une couverture équivalente de tous les fournisseurs.
Mesurer le bénéfice sur vos propres incidents
Choisissez des incidents historiques dont la cause est connue. Vérifiez si le système retrouve les machines et les tâches touchées, combien d’alertes il produit et quelles preuves soutiennent sa proposition. Conservez des cas qui n’ont pas servi au réglage des seuils pour éviter de mesurer seulement ce réglage.
Sur des essais contrôlés, mesurez le délai entre l’apparition du problème et sa détection, puis entre sa détection et le rétablissement. Le MTTR, temps moyen de réparation ou de rétablissement selon votre définition, doit utiliser un début et une fin identiques entre comparaisons. Un diagnostic accéléré ne supprime pas une attente de pièce de remplacement.
Reliez ensuite ces délais au travail affecté. Dans une hypothèse de 32 GPU réservés pendant 10 minutes sans progression utile, la réservation représente environ 5,33 GPU-heures. Cela ne mesure ni l’énergie gaspillée ni un gain imputable à Minerva. Ce calcul montre pourquoi une interruption courte peut immobiliser une capacité importante lorsqu’elle touche un groupe de machines.
Mesurez enfin le coût de l’observation : ressources de collecte et de stockage, conservation des données, temps de configuration et charge imposée aux équipements. Le bon résultat combine des incidents mieux traités avec une surcharge acceptable et un service qui atteint ses objectifs.
Faut-il s’y intéresser pour un petit déploiement ?
Pour une machine locale, commencez par les mesures du moteur d’inférence, la mémoire, les températures et les traces nécessaires à votre problème. Une plateforme de corrélation de cluster demande une justification si vous n’avez ni dépendances distribuées ni difficulté récurrente de diagnostic.
Pour un parc multi-machine, l’intérêt augmente lorsque les mêmes symptômes traversent plusieurs couches et plusieurs équipes. Faites alors un essai limité sur un périmètre connu, vérifiez les accès et comparez des enquêtes complètes avant d’élargir la collecte.
Minerva mérite une évaluation si ses relations entre réseau, machines et tâches rendent une panne explicable plus vite. Sa valeur se juge dans les incidents résolus et le travail préservé, avec les limites de version et les conditions d’exploitation réellement disponibles.
Sources et méthode
Analyse documentaire au 1er novembre 2026, fondée sur le guide Minerva 1.0.1 et les annonces publiques. Les fonctions décrites dans le guide sont des capacités documentées ; les gains commerciaux et cas clients restent des déclarations NVIDIA, sans reproduction indépendante ici. Les exemples de requêtes, de débit utile et de réservation GPU sont hypothétiques.
L’annonce du 22 octobre, la page produit et la fiche technique présentent le positionnement. Le guide 1.0.1, son architecture et son modèle réseau étayent le fonctionnement.
La corrélation automatique, le cas des 81 anomalies et l’enquête RoCE documentent des mécanismes et exemples, sans établir de taux de réussite universel.
Les notes de version et le guide MCP priment pour les limites citées de cette version. L’export Prometheus, DCGM Exporter et la définition d’utilisation dans nvidia-smi permettent de situer les couches d’observation. Les recommandations d’évaluation sont notre analyse.
Les deux captures documentaires proviennent du guide d’interface 1.0.1 et du cas de retransmissions RoCE. Elles illustrent les vues commentées, sans attester un déploiement ou une mesure de LeCompute. Leurs fichiers sont datés du 30 avril 2026 ; la version précise de l’interface représentée n’est pas indiquée.