Une application mobile doit continuer à fonctionner autour du modèle
Un technicien utilise une application de terrain sur son téléphone. Un client lui écrit : « Je voudrais un rendez-vous le 12 novembre 2026 à Lyon ». L’application pourrait extraire la date et la ville sur place, préremplir son formulaire, puis demander confirmation. Ce scénario reste utile lorsque le réseau est indisponible, à condition que le modèle et les données nécessaires soient déjà sur l’appareil.
L’enjeu dépasse la réponse du modèle. Le téléphone doit conserver l’écran réactif, les documents du technicien et les autres processus. Charger un modèle qui prend trop de mémoire ou monopolise les ressources peut rendre cette petite fonction désagréable à utiliser. Un modèle plus compact devient intéressant s’il accomplit correctement la même tâche dans le budget de l’application.
C’est sous cet angle qu’il faut examiner LFM3-1.7B, le modèle de texte de Liquid AI. L’entreprise a présenté la famille LFM3 le 27 octobre 2026 pour des usages spécialisés, notamment sur appareil. Les variantes texte, vision et audio sont des checkpoints distincts. Ce dossier compare le modèle de texte à des Qwen identifiés et explique le chemin vers une application mobile ou un système embarqué.
L’analyse est arrêtée au 1er novembre 2026. Les mesures citées sont publiées par Liquid AI ; LeCompute n’a pas réalisé de benchmark matériel ni déployé LFM3 dans une application mobile. Les scénarios décrivent des usages à évaluer.
Ce qu’un téléphone ou un terminal de terrain pourrait en faire
Dans l’exemple du rendez-vous, le modèle reçoit du texte et produit des champs date et ville. Le logiciel vérifie ces valeurs avant d’afficher une proposition. Il conserve les permissions du calendrier et décide quand enregistrer la visite. LFM3 peut être évalué comme composant d’interprétation du message ; le reste de l’application garde la maîtrise de l’action.
Un autre usage serait d’aider un technicien à retrouver une consigne dans un manuel conservé sur son terminal. L’application recherche des passages pertinents, les fournit au modèle et affiche la réponse avec sa source. Le modèle de texte n’indexe pas spontanément toute la bibliothèque. La récupération documentaire et la vérification de l’explication font partie du produit à construire.
Un compte rendu d’intervention peut aussi être transformé en champs à relire : équipement concerné, symptôme, opération effectuée. Si l’utilisateur dicte ce compte rendu, un composant de transcription doit d’abord produire le texte. De même, lire une photographie nécessite une étape de vision ou d’OCR. Le checkpoint LFM3-1.7B étudié ici reçoit du texte ; les variantes multimodales de la famille ne sont pas incluses automatiquement.
Ces fonctions sont aussi envisageables avec Qwen. Leur intérêt pour LFM3 dépend de la qualité obtenue et des ressources utilisées sur l’appareil cible. Une règle déterministe reste préférable lorsqu’elle traite déjà correctement un format fixe.
Traiter le texte sur l’appareil peut éviter de l’envoyer à un modèle distant. Ce bénéfice vaut aussi pour un Qwen exécuté localement. Il faut encore examiner les outils de l’application : une recherche web ou un calendrier distant reste un échange réseau.
Face à Qwen, quels modèles compare-t-on ?
« Qwen » désigne une famille. Comparer LFM3-1.7B à un gros Qwen ne répond pas à la même question que le comparer à Qwen3.5-2B, plus proche en classe de taille. Le benchmark mobile de Liquid AI inclut Qwen3.5-4B, mais pas ce 2B. Il faut garder cette différence visible avant de regarder les barres de performance.
Dans ces noms, B renvoie à un ordre de taille en milliards de paramètres, les valeurs apprises par le modèle. Cette taille ne détermine pas à elle seule la mémoire utilisée ou la qualité d’une tâche.
| Modèle | Entrées documentées | Rôle dans ce dossier |
|---|---|---|
| LFM3-1.7B | Texte | Modèle compact évalué par Liquid AI sur iPhone |
| Qwen3.5-2B | Texte et images | Candidat plus proche en taille ; absent du benchmark mobile cité |
| Qwen3.5-4B | Texte et images | Comparaison chiffrée disponible, avec un modèle plus grand |
Les fiches Qwen3.5-2B et Qwen3.5-4B décrivent des modèles vision-langage. Si votre application doit lire directement une photo, cette capacité change le choix et le budget complet à mesurer. Il serait trompeur d’assimiler un test de génération de texte à une comparaison de toutes leurs fonctions.
La comparaison utile fixe donc une tâche : extraire les champs du rendez-vous avec le même niveau de réussite, sur le même téléphone, puis mesurer le temps et la mémoire nécessaires. Un modèle peut gagner sur le débit et perdre sur les erreurs à corriger.
Ce que montre le benchmark sur iPhone 17 Pro
Dans sa fiche d’évaluation, Liquid AI compare des fichiers de poids GGUF quantifiés en Q4_0, avec 32 768 tokens de contexte, une seule séquence et 100 tokens produits, avec offload GPU. Sur iPhone 17 Pro, les modèles tournent dans une application iOS fondée sur llama.cpp. LFM3 utilise une version prenant en charge son architecture ; les concurrents utilisent b11744.
| Mesure publiée | LFM3-1.7B | Qwen3.5-4B |
|---|---|---|
| Traitement de l’entrée, prefill | 1 061 tokens/s | 339 tokens/s |
| Génération, decode | 43,6 tokens/s | 15,5 tokens/s |
| Empreinte mémoire du processus | 1,90 Go | 4,53 Go |
Le prefill est le traitement du texte déjà fourni ; le decode produit la suite de la réponse. Les valeurs publiées donnent à LFM3 un avantage de débit et d’empreinte mémoire dans ce protocole. Pour une application, une empreinte plus faible peut faciliter la coexistence avec le reste du logiciel. Elle ne mesure pas la quantité totale de RAM libre du téléphone.
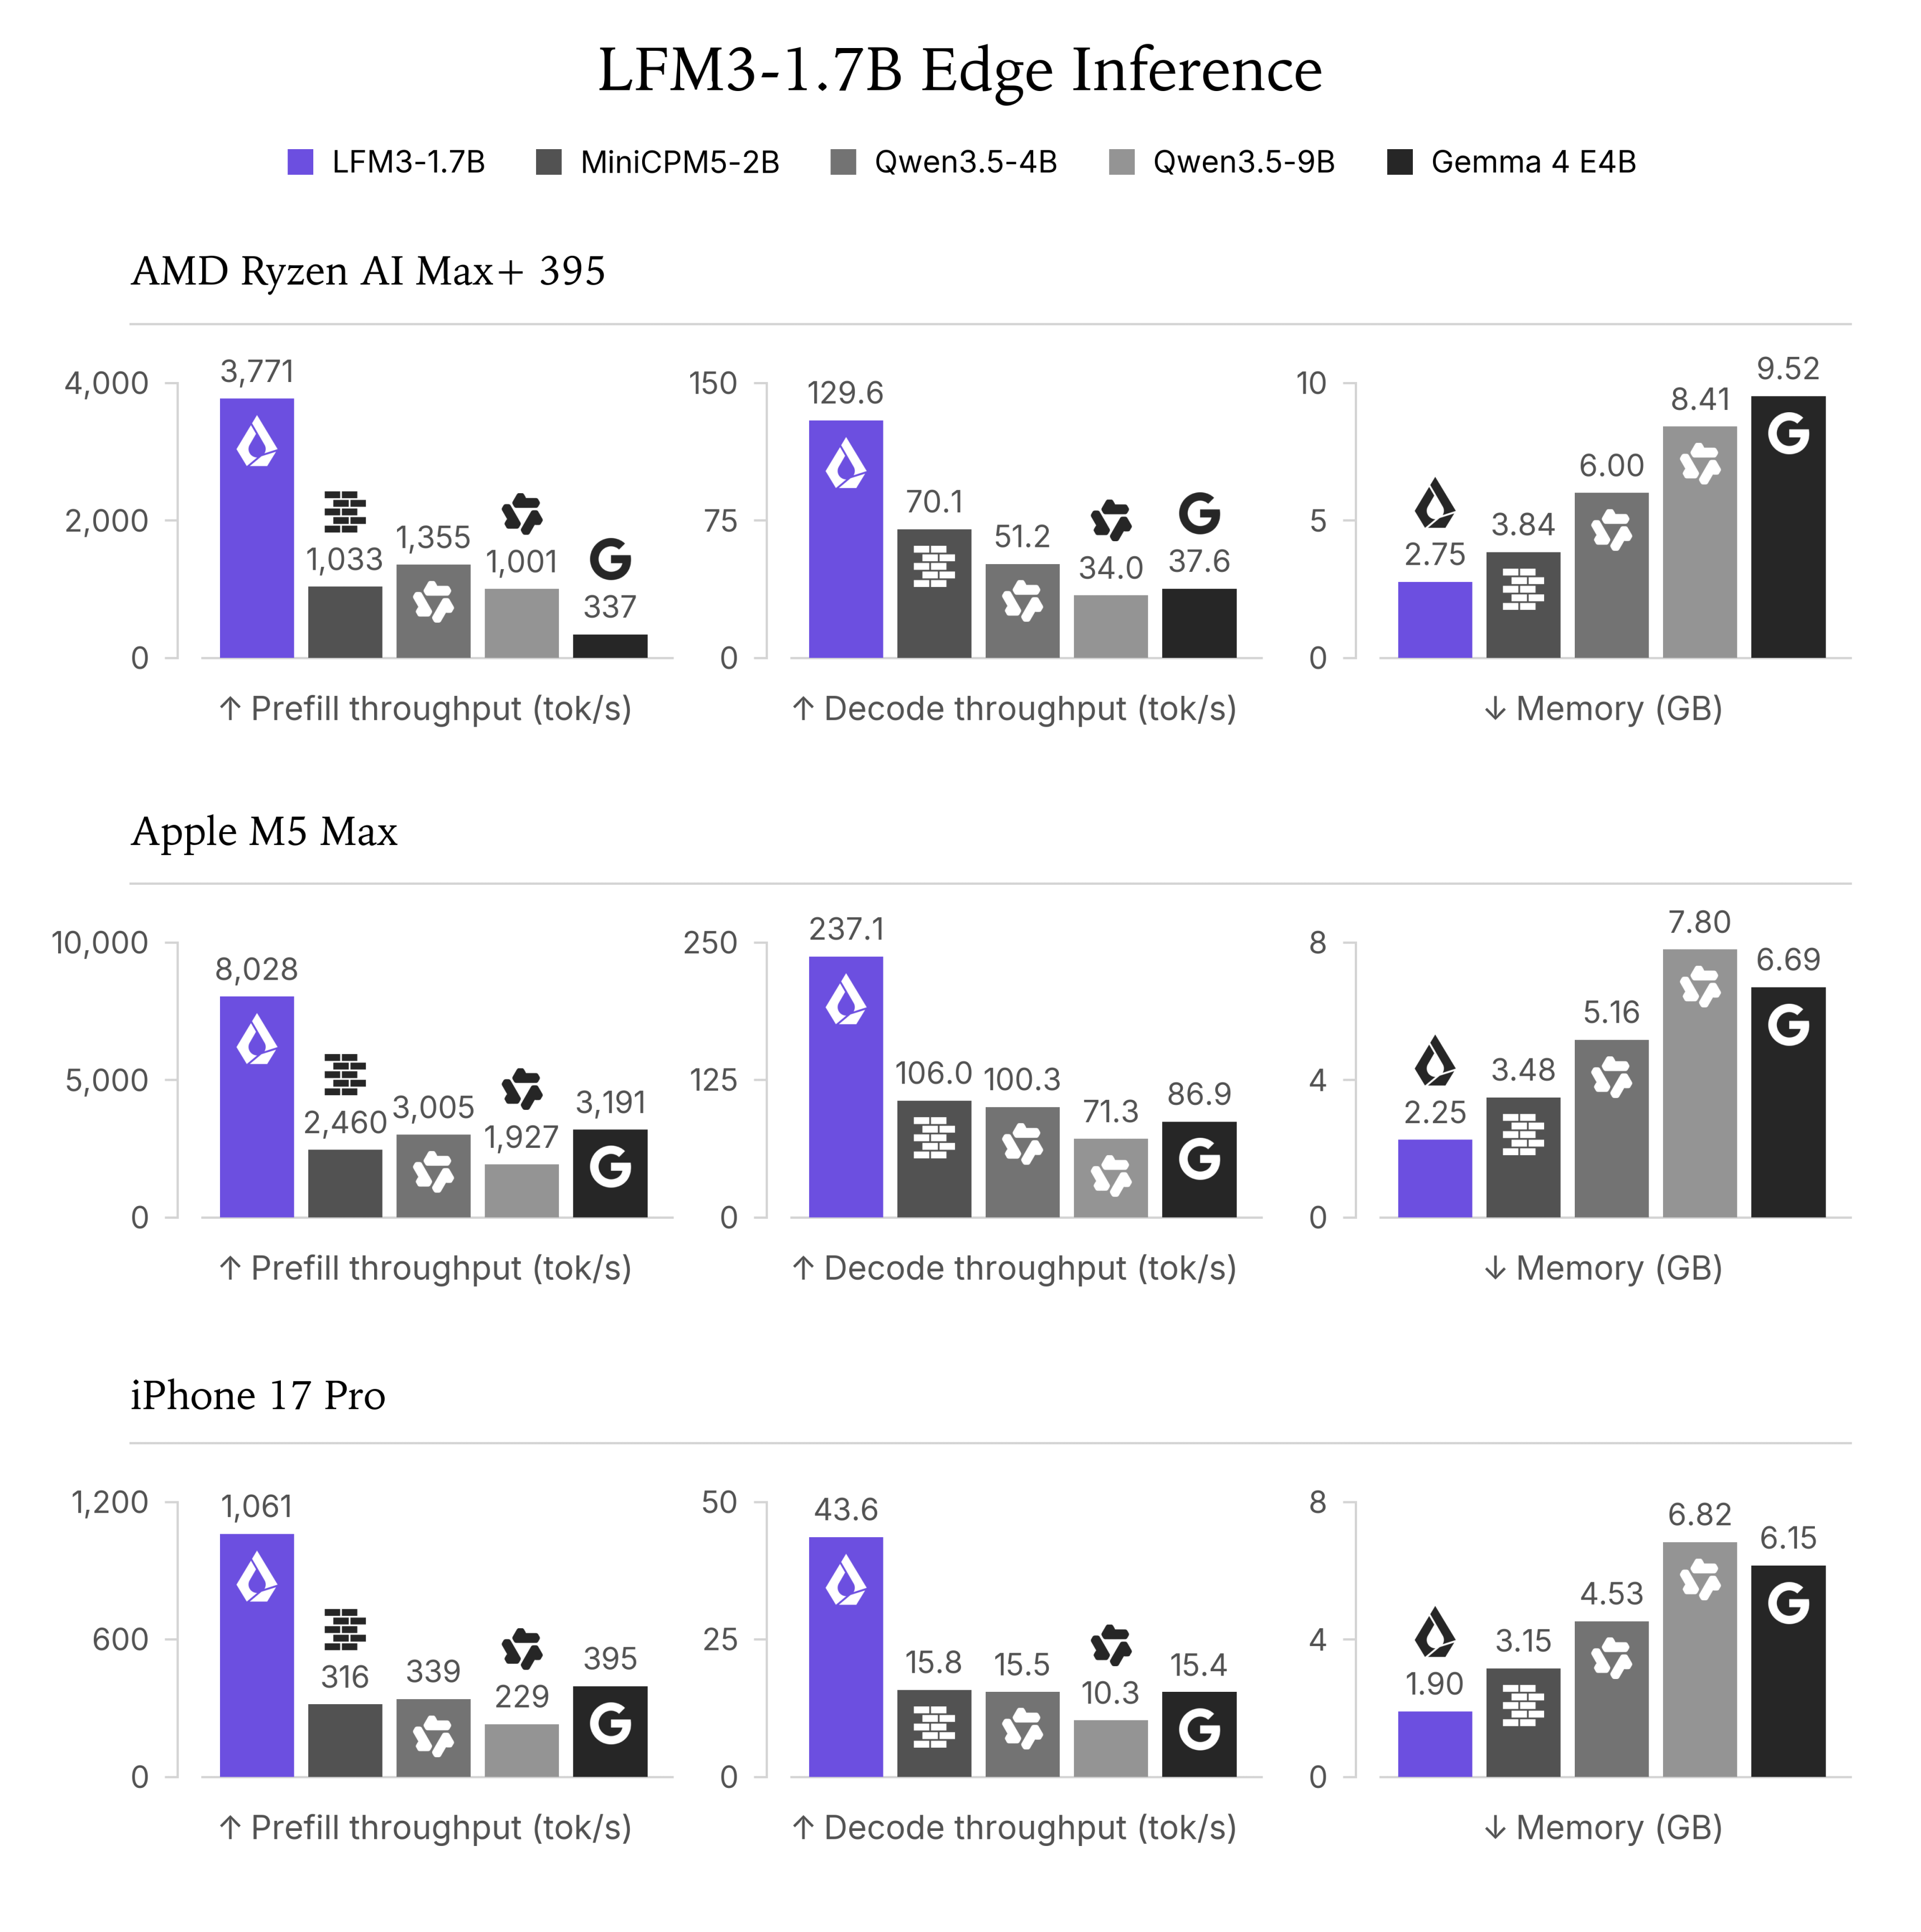
Le graphique complet contient aussi des résultats sur ordinateurs. Chaque ligne correspond à un appareil et chaque colonne à une mesure. Sur Apple, la mémoire est l’empreinte du processus, Metal compris ; sur AMD, le fournisseur additionne des pics hôte et GPU qui peuvent survenir à des instants différents. Les valeurs ne doivent pas être mélangées comme si elles provenaient d’un même téléphone.
Ce benchmark ne démontre pas une meilleure autonomie ou une chauffe moindre. Il ne fournit pas de mesure d’énergie par tâche ni de tenue du débit après des usages répétés. Un essai à contexte 32K ne représente pas non plus automatiquement le petit message de rendez-vous. Ces points demandent des mesures adaptées à l’application.
Plus rapide ne signifie pas meilleur sur toutes les demandes
Liquid AI publie aussi des résultats de qualité. Sur RULER 128K, un benchmark de traitement d’informations dans un long contexte, la fiche rapporte 65,56 pour LFM3-1.7B et 84,63 pour Qwen3.5-4B. Cette évaluation utilise vLLM en BF16, un format à 16 bits, avec une fenêtre maximale de 262 144 tokens pour ces deux modèles ; le réglage général annoncé est une température de 0,6 et un top_p de 0,95. Elle est distincte de l’inférence Q4_0 sur iPhone.
Cette différence suffit à écarter une conclusion universelle : le modèle le plus économe dans le graphique mobile ne domine pas chaque tâche de qualité. Elle ne prédit pas non plus votre extraction de rendez-vous quantifiée. Pour choisir, mesurez directement les champs corrects, les informations inventées et les demandes de précision sur vos exemples.
La fiche déconseille le codage agentique et les raisonnements complexes à plusieurs étapes pour ce petit modèle. LFM3 doit gagner sa place sur le travail réellement confié à l’application, et la comparaison avec Qwen3.5-2B reste à réaliser dans le protocole mobile cité. Aucun chiffre pour ce dernier n’est extrapolé ici.
L’architecture hybride compte, mais Qwen est hybride aussi
Le fichier de configuration LFM3 décrit 24 couches : 13 convolutions courtes, 5 attentions à fenêtre glissante et 6 attentions globales. Les premières gardent un état local ; l’attention à fenêtre glissante consulte une région récente ; l’attention globale permet des échanges avec des positions plus éloignées.
Ce mélange répartit les coûts. Conserver un état local borné ne demande pas le même stockage qu’un cache gardant toutes les clés et valeurs du contexte précédent. Les couches globales continuent toutefois à ajouter un coût qui croît avec la séquence. La qualité dépend également de l’apprentissage et de la manière dont le moteur exécute ces opérateurs.
Les configurations Qwen3.5-2B et Qwen3.5-4B associent, elles aussi, attention linéaire et attention complète. Les appeler de simples Transformers à attention complète opposés à un LFM « hybride » fausserait l’explication. Les variantes comparées ont des opérateurs, des dimensions et des logiciels différents ; l’étiquette d’architecture ne remplace pas leur mesure.
Sur téléphone, le fichier de poids n’est qu’une partie de la mémoire
Le dépôt GGUF propose des fichiers d’environ 1,05 Go en Q4_0 et 1,10 Go en Q4_K_M. Ce téléchargement s’ajoute au contexte, aux états de convolution, aux espaces de travail et à l’application. Le KV cache Mémoire des vecteurs clé et valeur déjà calculés pour chaque token traité par un LLM. Évite de recalculer l'attention sur tout l'historique, au prix d'une consommation mémoire qui croît avec le contexte. Approfondir dans le glossaire conserve les clés et valeurs calculées par les couches d’attention pour poursuivre la génération.
Un calcul pédagogique rend l’effet du contexte visible. Avec les 6 couches globales, 4 têtes KV de dimension 128, une seule séquence et un cache BF16 à deux octets par valeur, cette seule composante vaut :
cache global = couches × 2 (clés et valeurs) × têtes KV
               × dimension × tokens × octets

6 × 2 × 4 × 128 × 4 096 × 2 = 50 331 648 octets
Cela représente environ 50,3 Mo à 4 096 tokens, contre 402,7 Mo à 32 768 tokens, à hypothèses identiques. Ce sont des calculs de la partie globale, pas des mesures de llama.cpp ni la mémoire totale du modèle. Les attentions locales et les allocations propres au moteur restent à ajouter ; le format réel du cache peut aussi différer.
Pour le rendez-vous, l’application peut conserver le message, le fuseau horaire et les champs attendus. Charger des mois d’historique augmente le travail sans nécessairement aider à remplir le formulaire. La fenêtre maximale de 256K est une capacité annoncée du modèle ; elle n’est pas un réglage à appliquer par défaut sur téléphone.
Notre dossier sur la mémoire des LLM et le KV cache détaille les postes à additionner pour dimensionner le service.
Comment le modèle entre réellement dans une application mobile
Sur un ordinateur, on peut lancer un serveur puis lui envoyer des demandes HTTP. Sur téléphone, le guide mobile de Liquid AI présente plutôt une bibliothèque llama.cpp liée à l’application et appelée par son API native. Les poids GGUF résident sur l’appareil ; le calcul peut alors rester dans le processus de l’application.
Pour iOS, le guide décrit un XCFramework à intégrer dans Xcode. Pour Android, il s’appuie sur le NDK, les outils qui compilent la partie native C/C++, et l’exemple Android de llama.cpp. Les exemples de code de cette page utilisent notamment LFM2.5 : ils expliquent le portage, sans constituer une recette LFM3 déjà validée. Pour LFM3, il faut un moteur compatible, au minimum b11960 / v0.8.0 selon sa fiche GGUF, et le template de conversation du bon checkpoint.
L’application doit gérer le chargement, l’annulation d’une génération et la libération de la mémoire. Elle doit aussi exécuter le calcul hors du fil chargé de l’interface pour conserver un écran réactif. Le résultat textuel doit être converti en données puis contrôlé avant de devenir une action.
Le mot « local » n’implique pas l’utilisation du NPU ou du Neural Engine. Le backend doit savoir exécuter les opérateurs du modèle sur l’accélérateur choisi. Une mesure obtenue avec llama.cpp et un offload GPU ne prouve pas cette prise en charge sur tous les téléphones.
Dans un système embarqué, le même raisonnement vaut pour un terminal de maintenance ou une carte Linux capable d’héberger le moteur et ses allocations. Un petit microcontrôleur ne devient pas compatible avec un fichier de poids de l’ordre du gigaoctet par la seule présence du mot edge. La mémoire, les opérateurs pris en charge et le budget de calcul de la cible déterminent la faisabilité.
Comparer LFM3 et Qwen sur la cible que vous allez livrer
Préparez les mêmes demandes, dans les langues et les formats de votre application. Contrôlez d’abord les résultats acceptables, puis comparez le temps jusqu’à ce résultat. Les reprises et les corrections peuvent annuler un avantage de génération. Les découpages en tokens peuvent également différer entre modèles : le temps complet d’une tâche commune apporte une lecture que les seuls tokens par seconde ne donnent pas.
Utilisez une version de moteur prenant en charge les deux candidats, avec des backends et quantifications documentés. Conservez le template de conversation propre à chaque modèle. Le guide de migration Liquid AI signale notamment les différences de templates et de parsing d’outils : changer uniquement le nom du fichier peut produire un essai incorrect.
Mesurez le chargement à froid, le délai avant le premier résultat, le temps de fin et le pic mémoire de l’application complète. Répétez ensuite les usages sur la durée et observez l’énergie consommée, l’état thermique et l’évolution des délais, dans des conditions comparables. Une bonne valeur au premier appel ne suffit pas à caractériser un téléphone sollicité de façon répétée.
Le benchmark publié à 32K sert de point de départ. Testez aussi le contexte court dont votre fonction a besoin et incluez Qwen3.5-2B si sa taille et ses capacités correspondent au besoin. Le choix final porte sur une tâche correcte dans les limites de votre produit, pas sur une marque gagnante sur tous les appareils.
Prototyper sur ordinateur avant de porter sur téléphone
Le parcours suivant vérifie la consigne, le téléchargement et le format de sortie sur ordinateur. Il ne mesure pas une application mobile. Vous pouvez commencer par la conversation graphique ou aller directement au serveur local pour l’intégrer à un programme. Pour le portage sur téléphone, reprenez ensuite la bibliothèque native décrite plus haut et mesurez sur la cible.
Essayer LFM3 sans coder avec LM Studio
Pour discuter avec le modèle, le parcours le plus accessible est une application graphique. La fiche GGUF officielle indique LM Studio sur Windows, macOS et Linux, avec un moteur llama.cpp 2.65.1 ou plus récent. Ce numéro désigne le moteur intégré, pas la version de l’application LM Studio elle-même. Vérifiez aussi les prérequis du logiciel pour votre ordinateur.
Dans la section Download LM Studio du site officiel, choisissez votre système et installez l’application de chat. Dans Discover, recherchez LiquidAI/LFM3-1.7B-GGUF, puis choisissez le fichier Q4_K_M du dépôt LiquidAI. Ce format contient les poids quantifiés que le moteur local sait charger. Le téléchargement fait environ 1,10 Go ; la mémoire nécessaire à l’exécution est plus élevée, comme expliqué plus haut.
Passez ensuite dans Chat et sélectionnez ce modèle dans le sélecteur de chargement. Pour commencer, réglez la longueur de contexte à 4 096 tokens et la température à 0,1. Le premier réglage limite le texte conservé pour cet essai ; le second réduit l’aléa de génération sans garantir une réponse identique à chaque lancement. Le guide de démarrage de LM Studio distingue bien le téléchargement du fichier et son chargement en mémoire : il faut effectuer les deux avant de discuter.
Copiez cette consigne dans la conversation :
Extrais la date et la ville du message suivant.
Réponds uniquement avec un objet JSON contenant les clés date et ville.
Écris la date au format AAAA-MM-JJ. N'ajoute aucun autre texte.
Message : Je voudrais un rendez-vous le 12 novembre 2026 à Lyon.
Le résultat à rechercher est le suivant. C’est la réponse attendue pour cet exercice, pas une sortie mesurée par LeCompute :
{
  "date": "2026-11-12",
  "ville": "Lyon"
}
Vérifiez les valeurs, puis essayez une phrase ambiguë ou une ville différente. Vous utilisez ici un modèle local dans une conversation. Il ne consulte pas encore votre calendrier et ne réserve rien. Une fois le moteur et les poids téléchargés, cette conversation peut fonctionner hors ligne, sans outil externe ; la documentation LM Studio précise quelles opérations demandent encore Internet.
Lancer un serveur LFM3 sur un PC Windows
Le serveur devient utile si vous voulez intégrer ce traitement à un programme. Votre application lui envoie un message par HTTP et reçoit la réponse, au lieu de dépendre d’un copier-coller dans une fenêtre de chat. Vous pouvez choisir ce parcours directement, sans installer LM Studio en parallèle.
Pour un PC Windows x64 à processeur Intel ou AMD, ouvrez la release llama.cpp b11960 et téléchargez l’archive Windows x64 (CPU), nommée llama-b11960-bin-win-cpu-x64.zip. Cette version correspond à v0.8.0, le minimum indiqué pour LFM3 par Liquid AI. Décompressez l’archive dans un dossier et conservez tous ses fichiers ensemble, y compris les DLL. Pour Windows ARM, prenez l’archive ARM correspondante, pas celle de ce parcours x64.
Ouvrez PowerShell dans le dossier qui contient llama-server.exe. La commande suivante doit afficher la version du programme :
.\llama-server.exe --versionLancez ensuite le serveur. Cet exemple utilise volontairement le CPU pour commencer sans configuration CUDA :
.\llama-server.exe -hf LiquidAI/LFM3-1.7B-GGUF:Q4_K_M -c 4096 -np 1 -ngl 0 --host 127.0.0.1 --port 8080 --alias lfm3-local --temp 0.1 --top-k 50 --repeat-penalty 1.1-hf télécharge les poids depuis Hugging Face si nécessaire, puis les conserve dans le cache du moteur. -c 4096 fixe le contexte de cet essai, -np 1 réserve un seul emplacement de traitement et -ngl 0 désactive le placement des couches sur GPU. Le nom lfm3-local servira à identifier le modèle dans les appels de votre application. L’écoute sur 127.0.0.1 reste limitée à votre ordinateur.
Laissez cette fenêtre ouverte : c’est elle qui fait tourner le serveur. Le premier lancement comprend le téléchargement et le chargement du modèle. Quand il est prêt, ouvrez vous-même http://127.0.0.1:8080 dans votre navigateur pour retrouver l’interface de chat fournie par llama.cpp. Vous pouvez y reprendre le message de rendez-vous.
Pour vérifier le serveur depuis une seconde fenêtre PowerShell, utilisez son point de contrôle documenté :
Invoke-RestMethod -Uri 'http://127.0.0.1:8080/health'La réponse doit indiquer status: ok. Une réponse HTTP 503 pendant le chargement signifie qu’il faut attendre avant d’envoyer la demande. Pour arrêter le moteur, revenez dans sa première fenêtre et appuyez sur Ctrl+C.
Sur macOS ou Linux, choisissez l’archive adaptée au système et au processeur dans la même release. Depuis le dossier de l’exécutable, utilisez ./llama-server à la place de .\llama-server.exe, avec les mêmes arguments pour cet essai CPU. Une exécution accélérée demande ensuite un binaire et un backend adaptés à votre GPU ; elle n’est pas nécessaire pour comprendre le premier échange.
Envoyer une demande depuis votre propre programme
Gardez le serveur précédent actif. Dans la seconde fenêtre PowerShell, ce client envoie le message à l’API locale /v1/chat/completions et affiche le contenu de la réponse. Il n’utilise ni service OpenAI ni clé de compte : llama.cpp expose localement un protocole compatible.
$payload = @{
  model = 'lfm3-local'
  messages = @(
    @{
      role = 'system'
      content = 'Extrais la date et la ville. Retourne seulement un objet JSON avec date au format AAAA-MM-JJ et ville.'
    },
    @{
      role = 'user'
      content = 'Je voudrais un rendez-vous le 12 novembre 2026 à Lyon.'
    }
  )
  temperature = 0.1
  max_tokens = 128
  response_format = @{ type = 'json_object' }
}

$body = $payload | ConvertTo-Json -Depth 8
$response = Invoke-RestMethod -Uri 'http://127.0.0.1:8080/v1/chat/completions' -Method Post -ContentType 'application/json; charset=utf-8' -Body ([System.Text.Encoding]::UTF8.GetBytes($body))
$response.choices[0].message.content

$fields = $response.choices[0].message.content | ConvertFrom-Json
if ($fields.date -ne '2026-11-12' -or $fields.ville -ne 'Lyon') {
  throw 'La date ou la ville ne correspond pas au message de cet exercice.'
}
Le serveur choisit le modèle grâce à l’alias lfm3-local, traite la conversation et renvoie une réponse HTTP. Son champ choices[0].message.content contient le texte généré. Le mode json_object contraint sa forme à du JSON ; il ne prouve pas que la date et la ville sont correctes. Le client récupère donc ces champs avec ConvertFrom-Json, puis les compare aux valeurs attendues pour cet exercice. Une mauvaise date ou une mauvaise ville fait échouer le contrôle, même si la réponse était bien du JSON.
Le même échange peut venir d’un programme Python, JavaScript ou C++. Vous avez alors une première brique d’application locale : une fonction qui reçoit un texte et retourne des données à contrôler. Le calendrier, la base de clients ou l’envoi d’un message doivent encore être ajoutés explicitement par votre logiciel.
Si le premier lancement ne fonctionne pas
Si PowerShell ne trouve pas llama-server.exe, vérifiez le dossier courant : l’exécutable doit y être présent et le préfixe .\ doit figurer dans la commande. Un message signalant une architecture LFM3 inconnue indique qu’il faut vérifier la version du moteur ; la présence d’un fichier GGUF sur le disque ne suffit pas à le rendre compatible avec un ancien binaire. Dans LM Studio, vérifiez la version du moteur llama.cpp, distincte de celle de l’application. Si la CLI lms est disponible, lms runtime ls liste les moteurs installés et lms runtime update permet leur mise à jour, selon le guide officiel des runtimes.
Si le téléchargement échoue, rétablissez la connexion avant de relancer : le premier essai ne peut pas être hors ligne tant que les poids manquent. Si le serveur tourne mais que le client ne le joint pas, contrôlez son état avec /health et utilisez le même port dans les deux fenêtres. Enfin, si la mémoire manque, revenez à un contexte court, fermez les modèles déjà chargés et conservez un seul traitement pour ce premier essai. Le calcul de mémoire présenté plus haut explique pourquoi augmenter la fenêtre change le besoin en RAM.
Quand choisir LFM3, quand garder Qwen ?
LFM3 mérite un essai pour une fonction textuelle ciblée lorsque l’empreinte mémoire et la réactivité limitent l’application. Le résultat devient convaincant si la tâche réussit avec moins de ressources sur votre cible. Si un petit Qwen remplit déjà ces critères, le benchmark contre le 4B ne justifie pas à lui seul une migration.
Pour une fonction qui dépend des images, les capacités documentées de Qwen3.5-2B et 4B doivent entrer dans la comparaison, avec le coût du parcours complet. Une variante vision de LFM3 demanderait sa propre évaluation. Pour la parole, il faut également évaluer la transcription ou le modèle audio choisi au lieu de l’attribuer au modèle de texte.
Les conditions de distribution comptent aussi. Les deux checkpoints Qwen cités affichent Apache 2.0 ; LFM3 utilise la LFM Open License v1.0, avec une condition d’usage commercial liée au chiffre d’affaires. Son seuil d’origine équivaut à environ 9,2 millions d’euros au taux indicatif de LeCompute ; cette conversion n’altère pas le texte contractuel. Vérifiez la licence applicable au checkpoint effectivement distribué.
Commencez par le même petit scénario sur ordinateur pour vérifier la consigne et le format, puis portez-le sur l’appareil avant de conclure sur la performance. L’intérêt de LFM3 sur téléphone ou en embarqué se démontre à cet endroit : une fonction utile et suffisamment fiable, avec une place acceptable dans les ressources du produit.
Sources et méthode
État documentaire au 1er novembre 2026. Les caractéristiques de configuration et les tailles de fichiers sont des faits vérifiables dans les dépôts publics. Les scores et mesures de lancement sont rapportés par Liquid AI. Les exemples d’application, le protocole proposé et le calcul de cache sont nos explications ; ils ne constituent pas des mesures matérielles de LeCompute.
L’annonce LFM3 du 27 octobre, la collection officielle, la fiche du modèle de texte et son fichier de configuration définissent le périmètre étudié. Les fichiers ont été consultés sur la branche publique main ; une reproduction doit enregistrer la révision exacte téléchargée.
Le dépôt GGUF documente les quantifications et les versions minimales annoncées. Le guide llama.cpp documente les options d’exécution générales. La section Performance de la fiche donne les conditions d’évaluation ; aucune vitesse universelle n’en est déduite.
Le calcul mémoire suppose une séquence, des clés et valeurs BF16, sans quantification ni partage, et ne compte que l’attention globale. Un Go vaut un milliard d’octets ; un Gio vaut 1 073 741 824 octets. La licence officielle reste la référence pour les conditions d’utilisation. La conversion informative utilise 1 USD = 0,92 EUR, convention mi-2026 de LeCompute.
Le graphique d’inférence est reproduit depuis les assets de la fiche officielle, révision ac2586a34f1a1c03329dbdcdefabd8b6478ddaa7, sous la LFM Open License v1.0 jointe à l’image. Le redimensionnement conserve les axes, les légendes et toutes les mesures. Les débits et empreintes mémoire commentés restent des résultats rapportés par Liquid AI.
Le parcours graphique s’appuie sur le démarrage de LM Studio, ses prérequis et son fonctionnement hors ligne. Le minimum de moteur 2.65.1 est donné par la fiche GGUF de Liquid AI. Le parcours serveur cible explicitement la release b11960 / v0.8.0 et son README serveur versionné, qui documente les options, /health et les réponses JSON. Les valeurs du rendez-vous sont des réponses attendues pédagogiques, pas des sorties observées du modèle. Les commandes ont été vérifiées contre ces références ; ce guide ne rapporte pas une installation ou une exécution de LFM3 réalisée par LeCompute.
Les fiches officielles Qwen3.5-2B et Qwen3.5-4B, ainsi que leurs configurations 2B et 4B, étayent les modalités, le mélange d’attentions et les licences déclarées. Le tableau iPhone retranscrit les données Liquid AI pour LFM3-1.7B et Qwen3.5-4B. Les scores RULER viennent de sa section Benchmarks, avec le protocole BF16 distinct décrit dans le texte. Aucun résultat mobile Qwen3.5-2B, aucune mesure d’autonomie et aucun gain thermique ne sont inventés ou déduits de ces données.
Le guide iOS et Android documente l’intégration native, avec des exemples notamment LFM2.5. Les guides d’évaluation matérielle et de migration précisent les points de mesure et de compatibilité. Le scénario mobile, les critères d’évaluation et le calcul à 4K/32K constituent notre analyse ; ils ne sont pas une application déployée ou un benchmark réalisé par LeCompute.