Ce que DeepSeek met à disposition
Télécharger les poids d’un modèle permet de récupérer les paramètres appris pendant son entraînement. Il reste à les charger, à organiser les calculs et à répartir les demandes. Deux équipes peuvent donc servir le même modèle sur des machines comparables et obtenir des délais ou des coûts très différents.
Le 20 octobre 2026, DeepSeek a publié DeepInfer, le moteur qu’il présente comme celui de ses services de production. Le dépôt, sous licence Apache 2.0, apporte une implémentation spécialisée pour DeepSeek-V4.1-Flash. La version examinée annonce la prise en charge des GPU NVIDIA SM100 et des accélérateurs Huawei Ascend 950. Son premier mode d’utilisation public est l’inférence hors ligne, c’est-à-dire l’exécution de demandes sans livrer d’emblée toute une API de production. Documentation officielle.
Cette publication donne une prise concrète sur une question que les poids seuls laissent ouverte : comment transformer la capacité des puces en réponses utiles ? Le code montre des choix de mémoire, de réseau et d’ordonnancement. Il révèle aussi la frontière entre ce moteur et l’infrastructure qui l’entoure.
Une requête traverse plus que le modèle
Vous envoyez un long document à un assistant, puis posez une seconde question sur le même texte. Le service a intérêt à réutiliser une partie du travail effectué pour la première demande. Il doit retrouver cet état, choisir les machines qui vont traiter la suite et acheminer les données au bon endroit.
Le prefill Phase initiale d'une inférence LLM : les tokens du prompt sont traités en parallèle pour construire l'état du contexte. Cette réutilisation augmente l'intensité arithmétique et peut rendre la phase limitée par le calcul ; le régime exact dépend du modèle, du batch, du contexte et du backend. Approfondir dans le glossaire est la phase qui traite les tokens d’entrée, les morceaux de texte manipulés par le modèle. Le decode Phase de génération autorégressive d'un LLM : un token est produit à la fois en relisant les poids et l'état de contexte utile. À faible batch, ce trafic peut limiter le decode par la bande passante mémoire. Sa part dans le coût total dépend toutefois des longueurs d'entrée et de sortie, du batching et de la réutilisation du cache. Approfondir dans le glossaire produit ensuite la réponse progressivement. Le KV cache Mémoire des vecteurs clé et valeur déjà calculés pour chaque token traité par un LLM. Évite de recalculer l'attention sur tout l'historique, au prix d'une consommation mémoire qui croît avec le contexte. Approfondir dans le glossaire conserve des informations intermédiaires de l’attention pour éviter de recalculer tout le contexte à chaque étape.
La documentation distingue explicitement ce qui reste nécessaire pour un service complet : le système de cache KV, l’assemblage des phases séparées de calcul et l’équilibrage entre répliques. Une réplique est ici un groupe de machines capable de prendre en charge des demandes. Répartir les requêtes entre ces groupes n’est pas la même opération que répartir les experts d’un modèle à l’intérieur d’un groupe.
Le projet séparé deepseek-recipe traite une autre frontière : la conversion des requêtes et des réponses entre formats d’API. Il aide à rendre le modèle accessible aux applications, mais son appelant doit fournir le moteur, le transport et l’exécution des outils. Cette séparation rend les composants réutilisables sans transformer leur juxtaposition en service prêt à exploiter. Documentation de Recipe.
Les experts doivent travailler au bon endroit
DeepSeek-V4.1-Flash utilise un MoE Mixture-of-Experts. Architecture où le réseau est découpé en de nombreux « experts » dont un routeur n'active qu'un petit sous-ensemble par token. Le calcul par token suit le nombre de paramètres actifs ; la mémoire, elle, suit le nombre total, car tous les experts doivent rester résidents en VRAM, prêts à être sollicités. Approfondir dans le glossaire , ou mélange d’experts. Pour chaque token, le modèle sélectionne certains sous-réseaux plutôt que de mobiliser tous les experts disponibles. Ces experts peuvent être répartis entre plusieurs accélérateurs : chaque machine conserve une partie des poids, mais les données doivent rejoindre les experts choisis puis revenir dans la suite du calcul.
Imaginons que les demandes sollicitent davantage les experts placés sur une machine. Les autres peuvent terminer leur travail et attendre celle-ci. Ajouter des cartes ne corrige pas automatiquement ce déséquilibre. Le logiciel doit observer la charge, déplacer les experts ou créer des copies de ceux qui sont très demandés.
DeepInfer publie précisément une politique de placement et de réplication. Elle constitue une partie importante du parallélisme d'experts Mode de découpage d'un MoE où chaque GPU héberge un sous-ensemble des experts, au lieu de recevoir une tranche de chaque matrice comme en parallélisme tensoriel. Le token doit donc voyager jusqu'aux GPU qui détiennent les experts choisis pour lui : la communication devient un all-to-all et non un all-reduce. Souvent abrégé EP. : la distribution du modèle doit rester compatible avec la distribution réelle du travail. Les communications et les lectures de poids deviennent aussi importantes que la vitesse des multiplications. Politique d’équilibrage.
Cette logique explique pourquoi une performance mesurée sur un grand groupe de GPU ne se transpose pas à une carte isolée. Chaque accélérateur participe à un système dont le placement, les lots et l’interconnexion influencent le résultat. Notre analyse des MoE, du batch et du réseau détaille ce lien entre quantité de travail et coût des échanges.
Réduire le travail avant de chercher plus de puissance
Le moteur exploite aussi les particularités du modèle pour éviter certains calculs. V4.1-Flash partage une partie des informations d’attention entre couches. Dans certaines couches du décodeur, DeepInfer peut alors reconstruire l’état nécessaire en rejouant une portion bornée de la fin du prompt, au lieu de retraiter toute cette séquence dans ces couches.
Le détail est décisif : cela ne signifie pas que le modèle ignore le début du document. L’information antérieure a déjà été traitée par d’autres parties de son architecture. Le rapport technique décrit néanmoins des états reconstruits approximativement et une adaptation pendant le post-entraînement. Cette optimisation doit donc être jugée avec les évaluations de qualité du modèle, pas seulement avec un compteur de tokens. Rapport V4.1-Flash, section 3.2.2.
Autre levier, le speculative decoding Technique d'accélération du decode qui utilise un petit modèle rapide (draft model) pour proposer plusieurs tokens candidats, ensuite vérifiés en un seul passage par le modèle principal. Les tokens corrects sont acceptés sans coût supplémentaire : on échange du calcul redondant contre une réduction du nombre de passes autorégressives. Approfondir dans le glossaire fait proposer plusieurs tokens par un modèle de brouillon avant vérification par le modèle principal. Si les propositions sont acceptées, plusieurs positions avancent ensemble. Si elles sont rejetées, une partie du travail de proposition et de vérification n’a pas fait progresser la réponse.
La méthode DSpark utilise une estimation de confiance pour choisir combien de propositions vérifier. Une requête dont les brouillons sont peu prometteurs n’a pas nécessairement intérêt à occuper autant de place qu’une autre dans le lot de vérification. Le choix dépend aussi de la façon dont le matériel traite ce lot. L’ouverture rend cette coordination inspectable ; la méthode elle-même avait été publiée avant DeepInfer. Publication DSpark.
Enfin, le CPU prépare les lots pendant que les accélérateurs calculent. Ce recouvrement réduit les intervalles où les GPU attendent la prochaine décision du logiciel. Il reste pertinent même avec des kernels très rapides : accélérer une étape de calcul rend les délais entre étapes proportionnellement plus visibles. Ordonnanceur du moteur.
Un million de tokens par seconde demande un dénominateur
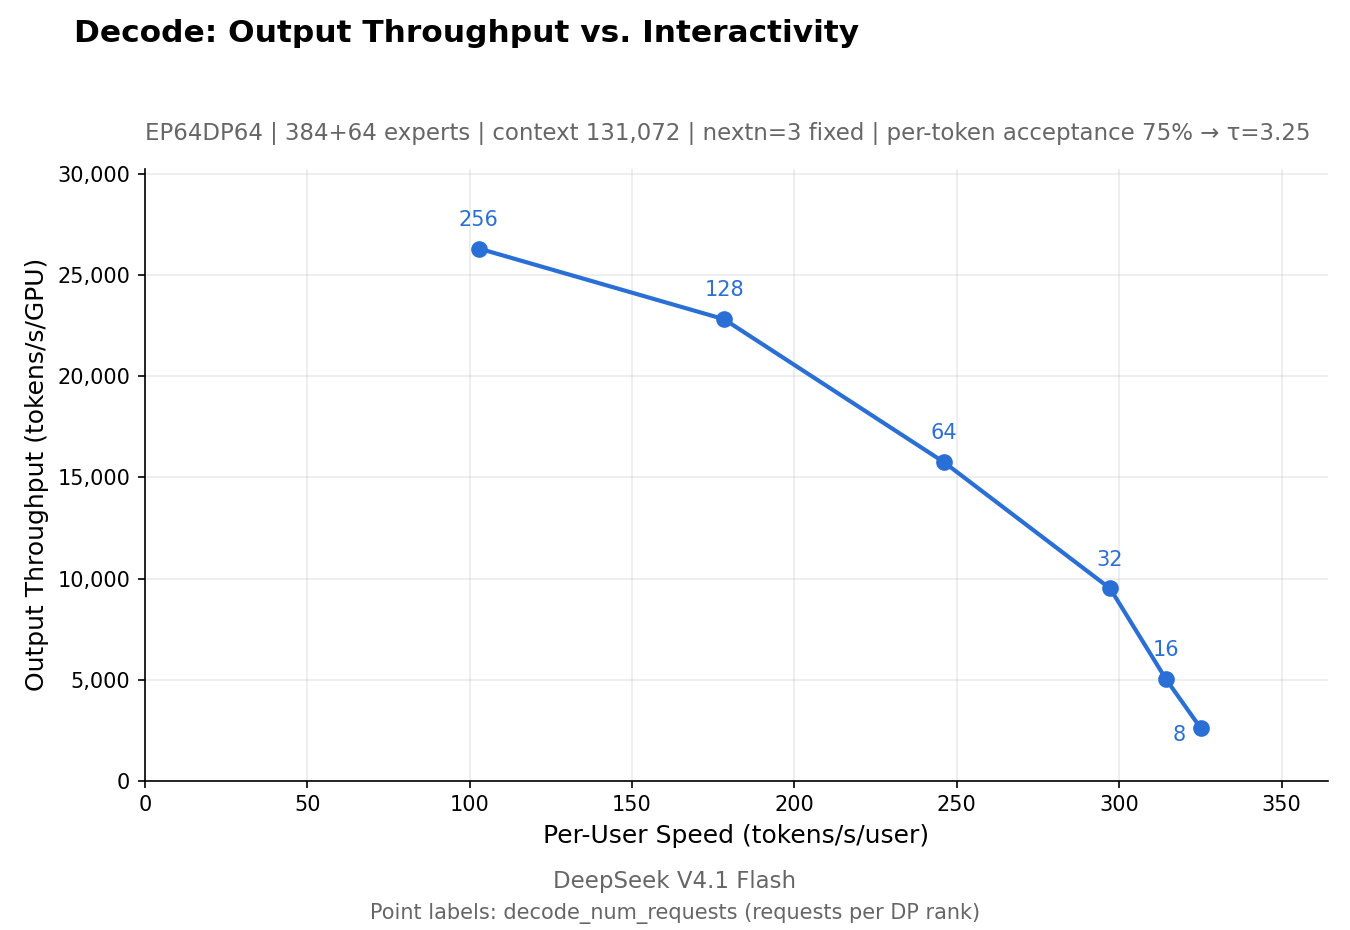
La courbe de génération officielle permet d’obtenir, à un de ses points, un ordre de grandeur d’un million de tokens par seconde pour un groupe de 64 GPU SM100. Ce total est calculé à partir d’environ 15 700 tokens par seconde et par GPU, lus sur le graphique. Il ne correspond ni à la vitesse d’un utilisateur ni à celle d’une carte seule. Courbe officielle.
Au même point, la courbe indique environ 246 tokens par seconde et par utilisateur, avec 64 requêtes par rang de calcul. Le protocole emploie un contexte de 131 072 tokens, trois propositions spéculatives et un taux d’acceptation fourni de 75 %. Le tracé convertit les étapes de calcul en tokens à partir de cette hypothèse d’acceptation. Il faut conserver cette condition pour interpréter le nombre affiché.
Les scripts ajoutent d’autres conditions : tokens aléatoires, équilibrage forcé des experts, échauffement et réutilisation d’un préfixe déjà calculé. Ils mesurent un fonctionnement stabilisé. Ils ne reproduisent pas à eux seuls les arrivées irrégulières de clients, les défauts de cache, les files d’attente et les interruptions d’un service. Protocole et scripts.
| Indicateur | Ce qu’il permet de lire | Ce qu’il faut encore mesurer |
|---|---|---|
| Tokens par seconde pour le groupe | Quantité de texte produite sous la charge testée | Résultat sous une contrainte de latence utilisateur |
| Tokens par seconde et par GPU | Débit du groupe normalisé par son nombre de cartes | Performance d’une configuration plus petite |
| Tokens par seconde et par utilisateur | Vitesse individuelle au point de concurrence choisi | Attente avant le premier token et ralentissements en queue de distribution |
Cette distinction protège aussi les comparaisons avec vLLM ou SGLang. Changer la topologie, le taux de cache ou la longueur des réponses peut suffire à changer le classement. Le dépôt ouvre une référence technique ; un classement universel des moteurs demanderait un protocole commun.
Le débit du moteur ne mesure pas la file d’attente
La courbe permet de lire un arbitrage concret. Vers sa gauche, davantage de requêtes partagent les ressources : le groupe produit plus de tokens au total, mais chaque utilisateur avance moins vite. À droite, le service privilégie la vitesse individuelle et laisse passer moins de texte par seconde pour l’ensemble. Le meilleur point dépend donc du délai acceptable pour l’application, pas du seul maximum de débit.
Une demande peut aussi attendre avant d’entrer dans le lot mesuré. Pour un assistant interactif, ce délai compte autant que la vitesse de génération : une réponse rapide une fois commencée peut arriver trop tard si le service a accumulé une file. Ajouter des demandes au benchmark et augmenter le rythme d’arrivée des clients sont deux expériences distinctes.
Pour évaluer un déploiement, une expérience utile serait de conserver le même ensemble de prompts, puis d’augmenter progressivement leur rythme d’arrivée. Il faudrait relever l’attente avant le premier token, la vitesse pendant la réponse et la part des requêtes qui respectent le délai visé, en séparant les cas où le préfixe est réutilisé et ceux où il faut le recalculer. Ce protocole proposé compléterait les mesures hors ligne ; aucun résultat de ce type n’est revendiqué ici.
Le coût du token reste un problème de service
Un token d’entrée retrouvé dans le cache n’exige pas le même travail qu’un nouveau token à traiter. Un token de sortie ajoute encore une autre charge. Additionner ces catégories décrit un volume de service, mais ne suffit pas à mesurer une puissance de calcul ni une efficacité économique.
Pour calculer un coût, il faut rapporter les dépenses du système au travail effectivement livré. Les accélérateurs continuent à coûter entre deux demandes. Le stockage du cache, les interfaces réseau, le refroidissement et les capacités de réserve ont aussi un prix. Une configuration qui maximise le débit peut devenir inacceptable si elle fait trop attendre chaque utilisateur.
Le tarif de l’API ajoute une décision commerciale à cette comptabilité. Il ne révèle pas directement le coût technique, et la publication d’un moteur ne démontre pas la cause d’une baisse de prix. Le code permet d’examiner des mécanismes d’économie ; il manque encore une mesure complète du service pour chiffrer leur résultat financier.
L’intérêt immédiat de DeepInfer est ailleurs : une équipe peut inspecter les choix de DeepSeek, tester une optimisation et comparer ses propres résultats à une référence spécialisée. Le projet reconnaît lui-même sa filiation avec vLLM et les apports de SGLang et TensorRT-LLM. L’ouverture remet donc des choix d’implémentation dans une circulation logicielle dont DeepSeek a aussi bénéficié.
Pour un exploitant, la suite utile consiste à comparer le temps nécessaire pour servir les mêmes demandes, avec la même qualité et les mêmes objectifs de latence. L’ouverture du moteur rend cette enquête plus concrète. Elle ne dispense pas de reconstruire le service autour de lui.
Sources et méthode
Analyse arrêtée au 1er novembre 2026, à partir du dossier de recherche LeCompute, du code et des publications citées. Référence DeepInfer : commit 553741557a57df44a46fb3ab72b6aafeaf945337. Aucun benchmark maison n’est revendiqué.
- Faits documentaires : README et licence du moteur, publication PyPI 0.1.0 et Recipe. L’emploi en production reste une déclaration de DeepSeek, sans audit de l’identité intégrale des versions.
- Mécanismes inspectables : cache local, politique d’experts et ordonnanceur liés dans le corps. V4.1-Flash et DSpark documentent les méthodes et leurs conditions.
- Mesures rapportées et estimation : la courbe decode fournit des valeurs approximatives lues sur image.
15 700 × 64 = 1 004 800est arrondi à un million, sans précision artificielle. L’acceptation de 75 % est un paramètre du tracé, pas une mesure sur les conversations des lecteurs. - Analyse : les conséquences sur la qualité de service et les coûts sont des raisonnements conditionnels. Aucun coût réel par token, gain universel ou résultat de parité NVIDIA/Huawei n’est déduit de ces courbes.