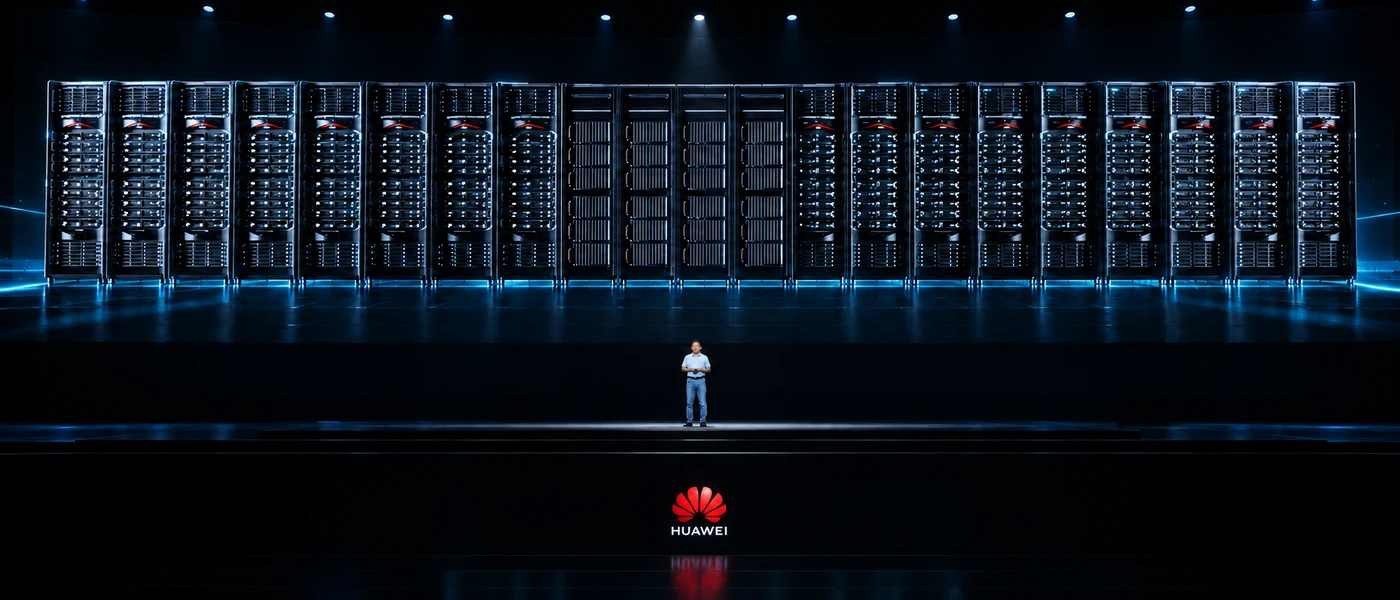
Le 17 septembre, à Shanghai, Huawei a présenté une machine dont l’ambition se comprend mieux en regardant les connexions que les processeurs. Atlas 960E doit réunir jusqu’à 4 096 NPU Neural Processing Unit. Accélérateur spécialisé dans les opérations des réseaux de neurones. Selon sa conception et son logiciel, il peut servir à l’inférence, à l’entraînement ou aux deux. Les opérateurs et formats pris en charge dépendent du matériel. Approfondir dans le glossaire , les accélérateurs de calcul de la gamme Ascend, dans un ensemble étroitement couplé. Huawei promet de mieux faire circuler les données entre eux, avec une interconnexion optique intégrée à son architecture UnifiedBus.
L’enjeu est considérable pour les grands modèles d’IA. Acheter davantage d’accélérateurs ne garantit pas de terminer un entraînement plus vite. Lorsque les puces passent une partie de leur temps à attendre des données ou leurs voisines, leur puissance théorique reste inutilisée. Huawei veut gagner sur cette attente.
Peut-on déplacer la compétition de la puce vers le système entier ? C’est la bonne question à poser à cette annonce. Elle oblige aussi à regarder ce que Huawei a réellement présenté, ce que son logiciel sait exploiter et ce que NVIDIA construit déjà à cette échelle.
Des milliers de puces doivent réussir à travailler ensemble
Un grand modèle peut répartir son calcul sur plusieurs accélérateurs. Chacun traite une partie du travail, puis transmet des résultats dont d’autres ont besoin pour continuer. La vitesse des échanges devient alors une composante du temps de calcul.
Le problème apparaît nettement dans les modèles à MoE Mixture-of-Experts. Architecture où le réseau est découpé en de nombreux « experts » dont un routeur n'active qu'un petit sous-ensemble par token. Le calcul par token suit le nombre de paramètres actifs ; la mémoire, elle, suit le nombre total, car tous les experts doivent rester résidents en VRAM, prêts à être sollicités. Approfondir dans le glossaire . Ces modèles dirigent chaque morceau de texte vers certains sous-ensembles de paramètres, les experts. Quand ces experts sont répartis sur plusieurs puces, le moteur doit acheminer les données vers les bonnes destinations, puis récupérer leurs résultats. Un accélérateur rapide peut attendre parce que les transferts prennent trop de temps ou qu’un expert reçoit davantage de travail que les autres.
Huawei propose de traiter un ensemble de machines comme un système plus étroitement intégré. UnifiedBus doit permettre aux composants de communiquer sous un même protocole et d’accéder à de la mémoire située au-delà de leur serveur physique. Cela peut élargir les possibilités de placement des données. La distance reste toutefois une contrainte : partager un espace d’adresses ne donne pas à toutes les mémoires le même temps d’accès.
Cette distinction compte pour la promesse industrielle. Une grande capacité mémoire n’aide que si le logiciel peut l’utiliser sans consacrer le gain attendu à déplacer les données. L’architecture doit donc rapprocher les ressources utiles et organiser les échanges, pas seulement les rendre accessibles.
Le rôle de ces transferts est détaillé dans notre analyse des modèles à experts et de leur réseau.
L’optique devient une partie de la machine
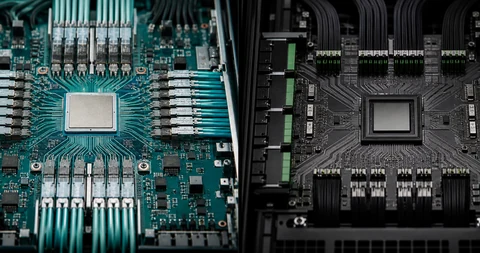
Atlas 960E s’appuie sur Hi-ONE, un moteur optique utilisant le near-packaged optics, ou NPO Near-Packaged Optics. Intégration qui rapproche les éléments optiques des circuits électroniques auxquels ils sont reliés. Elle réduit la distance électrique à parcourir et modifie la densité et la maintenance des liaisons. . Cette approche rapproche les éléments optiques des circuits électroniques auxquels ils sont reliés. Elle modifie l’intégration des liaisons, avec des conséquences sur leur consommation, leur densité et leur maintenance.
Huawei annonce que 5 500 moteurs Hi-ONE remplaceraient les 48 000 modules optiques 800G nécessaires à son architecture de référence. Le groupe revendique une réduction de puissance supérieure à 550 kW. Ce chiffre concerne la comparaison d’interconnexions présentée par Huawei ; il ne décrit ni la consommation totale d’Atlas 960E ni une économie mesurée face à un système NVIDIA. Annonce du 17 septembre.
L’intérêt de cette annonce dépasse pourtant le seul bilan électrique des liaisons. Elle montre jusqu’où Huawei veut définir son produit : accélérateurs, échanges et intégration physique sont conçus ensemble. L’acheteur est invité à juger une machine complète, avec ses choix d’exploitation, plutôt qu’à sélectionner séparément chaque composant.
La démonstration commerciale reste à venir
Le calendrier impose une première limite à l’enthousiasme. Huawei prévoit Ascend 960DT au premier trimestre 2027 et 960PR au troisième trimestre. La présentation d’Atlas 960E ne prouve donc pas qu’un client dispose déjà de la configuration annoncée en production.
Le résultat le plus spectaculaire sur l’efficacité du calcul demande une autre précision. Huawei annonce une utilisation du calcul multipliée par 2,75 dans une simulation d’un cluster de 100 000 NPU, organisé en grands ensembles de 4 000 NPU plutôt qu’en serveurs de huit. Cette simulation compare deux organisations du calcul. Elle ne mesure pas une avance sur une machine NVIDIA. Présentation de David Wang.
Huawei dispose néanmoins d’un précédent documenté. La publication sur CloudMatrix384 décrit l’exécution de DeepSeek-R1 et l’organisation du travail entre traitement de l’entrée et génération de la réponse. Elle donne des résultats pour un matériel, un modèle et des contraintes de service précis. C’est une preuve que l’effort système peut produire une implémentation mesurable, sur cette génération. Les résultats ne se transfèrent pas automatiquement à Atlas 960E. Étude CloudMatrix384.
Le logiciel décide du gain que le client récupère
Une architecture n’exécute pas directement une application. Entre les deux, le moteur d’inférence doit répartir le modèle, choisir ses opérations optimisées et organiser les communications. C’est à cet endroit qu’une capacité matérielle devient un gain, ou une difficulté d’intégration.
Les notes de vLLM-Ascend 0.23.0 montrent ce travail en cours. Elles détaillent les dépendances pour A2, A3 et Ascend 950, ainsi que les combinaisons encore limitées. Elles signalent notamment, pour DeepSeek V4 sur A2/A3 à forte concurrence, des pointes de délai entre tokens lors de recompilations de noyaux Triton, les petits programmes qui exécutent les opérations sur l’accélérateur. Cette limitation porte sur ces configurations, pas sur Atlas 960E. Notes de version.
Pour un client, ce détail peut peser davantage qu’un maximum théorique de calcul. Une API interactive doit répondre régulièrement ; un entraînement doit avancer pendant de longues périodes. Le temps passé à adapter les modèles, diagnostiquer les ralentissements et reprendre après une panne entre dans l’évaluation du système.
NVIDIA est déjà sur ce terrain
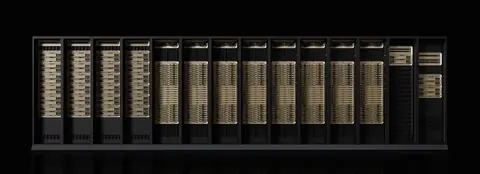
La stratégie de Huawei rencontre un concurrent qui vend lui aussi une architecture complète. DGX Vera Rubin NVL72 associe GPU, processeurs et interconnexion NVLink Interconnexion propriétaire NVIDIA entre GPU. NVLink 5 (Blackwell) atteint 1,8 To/s bidirectionnels par GPU ; NVLink 6 (Rubin) double à 3,6 To/s. Avec NVSwitch, elle accélère les échanges GPU-GPU et les collectifs ; les mémoires restent physiquement distribuées et un accès distant n'a pas le coût de la HBM locale. Approfondir dans le glossaire dans un système intégré. La compétition porte déjà sur la manière de faire travailler les composants ensemble. Présentation NVIDIA.
Comparer les nombres d’accélérateurs ne permet pas de départager ces approches. Une installation plus grande mobilise aussi davantage de mémoire, de puissance électrique, d’espace et d’équipements à maintenir. Il faut comparer ce qu’elle termine dans un délai donné, avec la qualité attendue, puis rapporter ce travail aux ressources engagées.
Huawei ouvre ainsi une piste sérieuse pour la concurrence : gagner de l’efficacité dans l’organisation du calcul, même lorsque la comparaison d’une puce isolée ne raconte pas toute l’histoire. Mais l’avantage commercial dépendra de la part de cette efficacité que les clients pourront reproduire.
Pour juger Atlas 960E, les prochaines preuves utiles seront donc des déploiements identifiés et des résultats complets : modèle, précision, latence, énergie du système et stabilité dans la durée. La promesse de Huawei mérite d’être examinée à l’échelle qu’il revendique. La preuve devra arriver à cette même échelle.
Sources et méthode
Cette analyse repose sur des sources consultées au 20 septembre 2026. Les annonces, caractéristiques et calendriers sont attribués aux deux communiqués Huawei. Leur existence est vérifiée ; leurs performances commerciales ne sont pas validées par une mesure LeCompute.
Le précédent expérimental est la publication CloudMatrix384, version 3. Le contrôle logiciel porte sur les notes vLLM-Ascend 0.23.0. La stratégie concurrente est documentée par la fiche DGX Vera Rubin NVL72. Aucun ratio de performance entre ces systèmes n’est calculé.
L’explication des échanges et les critères de comparaison relèvent de l’analyse technique. LeCompute n’a testé aucun de ces matériels pour cet article. Le calendrier retenu est celui des sources disponibles au 20 septembre 2026.