Coûts
Alibaba veut fournir la puce, le modèle et le cloud : que restera-t-il à choisir ?
Alibaba rapproche puces, modèles et services d’agents. Les poids ouverts laissent du choix, mais adaptations et données déterminent ce qui peut partir ailleurs.
Coûts
Alibaba rapproche puces, modèles et services d’agents. Les poids ouverts laissent du choix, mais adaptations et données déterminent ce qui peut partir ailleurs.
Kernel & Perf
FlashAttention-4 poursuit son développement sur Blackwell. Entre deux produits matriciels, le softmax et les mouvements de données peuvent imposer le rythme.
Silicon
AMD conteste NVIDIA Vera avec EPYC Venice. Les agents attendent aussi leurs outils : pourquoi les scores par cœur et par rack ne racontent pas la même chose.
Coûts
Google, NVIDIA et Emerald AI veulent accélérer les raccordements grâce à la flexibilité électrique. Qui garantira les réductions promises au réseau ?
Coûts
NVIDIA promet de préserver l’ouverture de Hugging Face. Qui organisera les chemins les plus simples pour choisir et déployer les modèles ?
Silicon
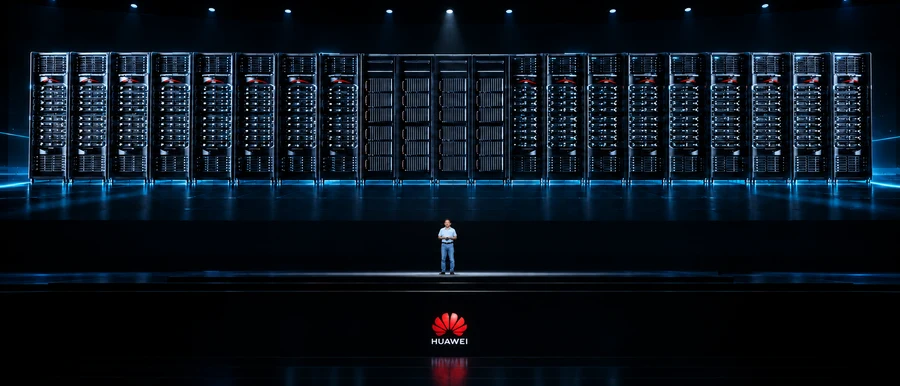
Huawei présente Atlas 960E et ses 4 096 accélérateurs annoncés. Peut-on déplacer la compétition de la puce vers le système entier ?
Kernel & Perf
Un réseau de neurones n'a pas de WCET exploitable pour la certification : le composant central de la conduite automatisée reste une boîte noire probabiliste. L'industrie ne le nie pas : elle déplace la garantie vers une couche qu'elle sait borner.
Runtimes
Le scheduler d'un moteur d'inférence n'arbitre pas entre débit et latence, mais entre deux latences : le temps jusqu'au premier token et le temps entre les suivants. Trois moteurs majeurs, trois défauts opposés, et rien ne le signale à celui qui déploie.
Runtimes
Un mixture-of-experts ne supprime pas le coût, il le déplace deux fois : du calcul vers la mémoire, puis de la mémoire vers le réseau. Le second basculement a un seuil, il se calcule, et c'est lui qui décide de votre topologie.
Coûts
Un modèle de conduite est une fonction de sa distribution de données. Mais le coût du transport n'est pas où on le croit : la perception se recale pour presque rien, le comportement non, et la validation domine tout. Le prix d'entrée sur un marché est une facture de simulation.
Runtimes
GGUF est un format de fichier, GPTQ et AWQ des algorithmes. À 4 bits, chacun attaque autrement le problème des valeurs aberrantes. Anatomie de trois constructions, de la Hessienne de GPTQ aux k-quants de GGUF, et de ce que le choix du format décide pour vous.
Coûts
10 gigawatts « sécurisés avec des années d'avance », 0,3 gigawatt branché à Abilene. Derrière la remontada d'OpenAI dans l'IA de codage, un pari compute qu'il faut lire en trois états : le sécurisé, le construit, le branché. Et une économie d'abonnements que les agents ont fait craquer.
Runtimes
Le 8 juillet 2026, OpenAI a désavoué SWE-Bench Pro : ~30 % de tâches cassées. C'est le troisième instrument de référence déclaré mort en trois générations. Anatomie d'une crise de métrologie : plafond de bruit, contamination, et un effet harnais qui vaut une génération de modèle.
Coûts
Le 8 juillet 2026, OpenAI désavoue le benchmark de référence du codage agentique. Le 9, il fusionne Codex dans l'app ChatGPT et lance GPT-5.6. Derrière la séquence, une remontada qui se joue moins sur l'intelligence que sur les prix, les forfaits et le harnais.
Runtimes
Quantification, GQA, MLA, fenêtre glissante, MoE, attention sparse, SSM : le zoo des techniques pour alléger un LLM est vaste. Plutôt qu'une liste, une carte rangée par la ressource qu'on attaque : les poids, le KV cache, le calcul par token, le matériel.
Runtimes
Gemma borne le KV cache ; les modèles à espace d'états, Mamba et ses hybrides, le suppriment, en remplaçant le cache qui enfle par un état de taille constante. Une mémoire qui ne suit plus le contexte, mais qui bute sur le rappel exact, ce qui a fait des hybrides le format gagnant de 2026.
Coûts
Le 12 juin 2026, Washington a coupé l'accès européen aux meilleurs modèles d'Anthropic. Le lendemain, un laboratoire chinois publiait GLM-5.2 sous licence MIT, au niveau de GPT-5.5 et Gemini, et que personne ne peut éteindre à distance. Anatomie d'un basculement, du silicium au coût par tâche.
Runtimes
Gemma 4 tient 256K tokens de contexte sans faire exploser la VRAM, grâce à une idée d'attention héritée de Gemma 3 : n'utiliser l'attention globale qu'une couche sur six, et fenêtrer toutes les autres. Comment ça marche, ce que ça coûte, et pourquoi la perplexité n'en souffre pas.