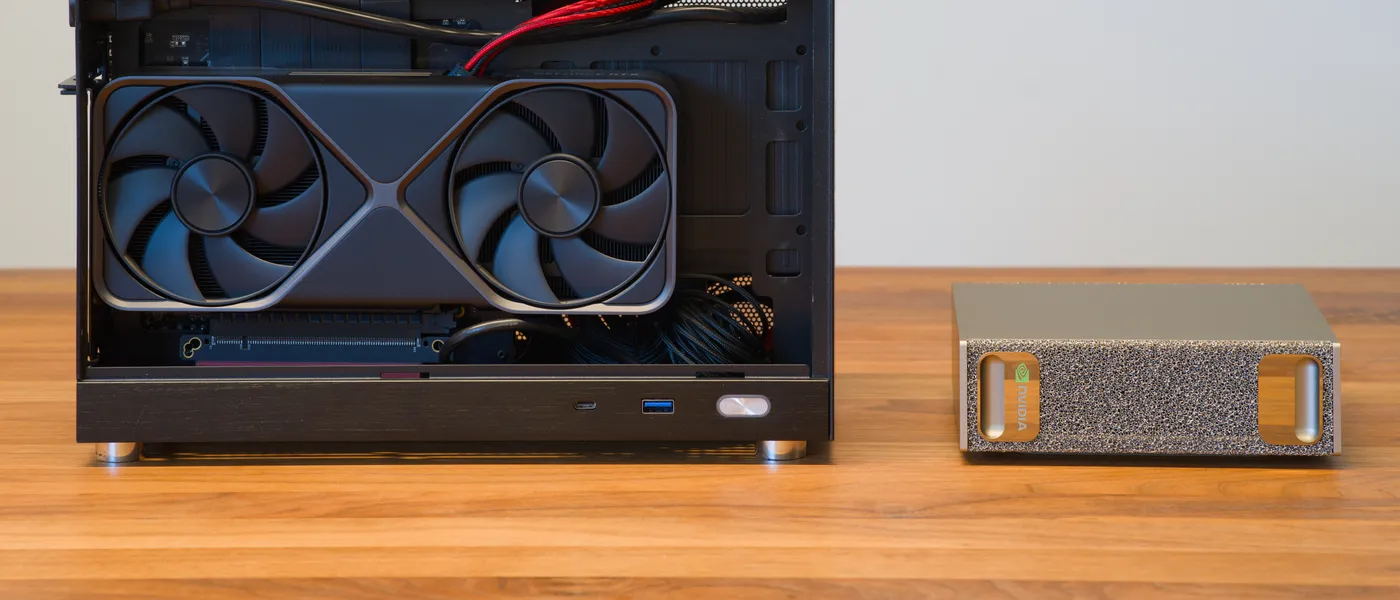
Deux objets que tout oppose, une seule question d’achat
D’un côté, une carte de 575 W qui exige un boîtier, une alimentation surdimensionnée et un flux d’air sérieux. De l’autre, un cube doré de la taille d’un livre, complet, silencieux, qui se pose à côté de l’écran. Tout les oppose, sauf le moment où on les compare : au prix où la pénurie a porté la RTX 5090 (3 900 à 4 400 € en rue pour 2 099 € de MSRP UE), le DGX Spark à environ 4 323 € joue dans la même enveloppe. À budget égal, il faut choisir. Et le bon critère n’est ni le pétaflop ni le nombre de cœurs : c’est la forme de votre charge.
Ce duel se résume à un arbitrage que notre guide de choix GPU érige en méthode : la mémoire élimine, la bande passante départage. Voici les deux fiches posées côte à côte, puis ce que les mesures en disent.
| DGX Spark (GB10) | RTX 5090 (bureau) | |
|---|---|---|
| Mémoire | 128 Go LPDDR5X unifiée | 32 Go GDDR7 |
| Bande passante | ~273 Go/s | ~1 792 Go/s (6,5×) |
| Cœurs CUDA | 6 144 (classe RTX 5070) | 21 760 |
| Consommation | machine complète, 240 W max (~170 W mesurés en charge) | carte seule, 575 W |
| Format | mini-PC autonome (Linux DGX OS) | carte à intégrer (PC complet requis) |
| Prix constaté | ≈ 4 323 € (MSRP officiel) | 3 900–4 400 € (rue, MSRP UE 2 099 €) |
Ce que les mesures disent : la bande passante décide
Sur un modèle dense servi en une seule séquence, le decode relit les poids actifs et le cache ; le trafic mémoire limite souvent le débit. Un MoE ne lit que les experts sélectionnés, et le batching partage la lecture des poids entre requêtes. LMSYS mesure environ 205 tokens/s sur la 5090 contre 50 sur le DGX Spark avec GPT-OSS 20B et Ollama. Ce rapport proche de quatre n’est pas une loi universelle ; il n’isole pas la mémoire des kernels, de l’ordonnancement et des coûts du runtime.
Le prefill Phase initiale d'une inférence LLM : les tokens du prompt sont traités en parallèle pour construire l'état du contexte. Cette réutilisation augmente l'intensité arithmétique et peut rendre la phase limitée par le calcul ; le régime exact dépend du modèle, du batch, du contexte et du backend. Approfondir dans le glossaire a une intensité arithmétique plus élevée, sans donner automatiquement l’avantage au Spark. Sur le même test Ollama 20B, la 5090 mène aussi au traitement du prompt. Mesurez séparément le délai du premier token, la latence du decode Phase de génération autorégressive d'un LLM : un token est produit à la fois en relisant les poids et l'état de contexte utile. À faible batch, ce trafic peut limiter le decode par la bande passante mémoire. Sa part dans le coût total dépend toutefois des longueurs d'entrée et de sortie, du batching et de la réutilisation du cache. Approfondir dans le glossaire et le débit agrégé.
Le verdict par taille de modèle
Modèles qui tiennent intégralement dans 32 Go : la 5090 est une candidate solide pour la génération interactive. Vérifiez le fichier quantifié, le contexte, le batch et les allocations du runtime. Le nombre de paramètres ne garantit pas à lui seul qu’un 30 B tient ; le rapport de quatre mesuré sur GPT-OSS 20B ne se transpose pas à tous les modèles.
Le 70 B dense : environ 42 Go de poids Q4_K_M dépassent déjà une 5090 seule. Le Spark peut les loger, sous réserve du contexte et des buffers. Les 2,7 tokens/s cités sont mesurés en FP8, pas en Q4_K_M : ils ne décrivent donc pas la vitesse du Q4. Avec une hypothèse de 70 Go de poids FP8, 273 / 70 donne un plafond simplifié de 3,9 tokens/s pour une séquence. Mesurez la quantification choisie avant de décider si la latence convient.
Les MoE de 100 B et plus : le Spark, par forfait de l’adversaire. Un GPT-OSS 120B (~65 Go de poids MXFP4, ~80 Go chargé) n’entre dans aucune carte grand public, 5090 comprise. Le Spark le charge et le sert à ~38 tokens/s mesurés en llama.cpp (~50 avec SGLang : le chiffre dépend du runtime), parce qu’un MoE ne lit qu’une fraction de ses poids par token : la capacité paie, la bande passante étrangle moins. C’est le seul segment où le duel n’a qu’un concurrent en lice, et c’est précisément la raison d’être du Spark.
Le duel élargi : RTX 5070, RTX 5090 Laptop et RTX Spark
Les recherches associent ce duel à d’autres noms, et les écarter proprement évite plusieurs erreurs d’achat. La première tient au nom lui-même : la RTX 5090 Laptop n’est pas une 5090 de bureau miniaturisée, c’est une autre puce (GB203, celle de la 5080 de bureau) avec 24 Go de GDDR7 à ~896 Go/s et 10 496 cœurs sous 95 à 150 W. Pour un LLM, lisez-la comme une très bonne carte 24 Go, avec moitié moins de bande passante nominale que la 5090 de bureau, sans déduction directe du débit applicatif ; tous les chiffres « 5090 » de cet article concernent la carte de bureau. La RTX 5070 partage son compte de cœurs CUDA (6 144) avec le GPU du Spark, ce qui en fait « l’équivalent calcul » sur le papier ; mais ses 12 Go de GDDR7 (~672 Go/s) la cantonnent aux modèles ~13 B en 4 bits. C’est une porte d’entrée honorable du LLM local, pas un rival du Spark : on ne compare pas 12 Go à 128. Le RTX Spark (N1X), attendu à l’automne 2026 sous Windows on Arm, est le cousin grand public du DGX Spark : jusqu’à 128 Go unifiés, mais une bande passante et un débit applicatif encore non confirmés. Un tarif inférieur à capacité égale n’est pas établi ; les estimations d’analystes (~2 667 €) ne concernent toutefois que ses configurations 16 à 32 Go.
Comment trancher
Commencez par le budget mémoire complet. Si poids, cache KV et runtime tiennent dans 32 Go, mesurez une 5090 sur votre cible de latence. Sinon, la capacité du Spark devient utile, notamment pour un grand MoE. Le choix d’un 70 B dense exige une mesure dans la quantification retenue. Comparez aussi deux systèmes complets : PC hôte, alimentation, mémoire, électricité et matériel déjà possédé. Le coût complet d’un serveur GPU prolonge cette décision.
Conclusion
Les mesures soutiennent un choix entre capacité et latence, pas un gagnant universel par nombre de paramètres. Notez la révision du modèle, sa quantification, le contexte, la concurrence, la version du runtime et le coût complet. Le RTX Spark reste une plateforme Windows distincte : les mesures ci-dessus ne prouvent ni sa bande passante ni un prix inférieur à configuration 128 Go identique.
Sources et méthode
Cet article est le spoke « Spark contre GeForce » de notre dossier Spark : les chiffres communs (fiche GB10, mesures, prix) sont établis et sourcés dans RTX Spark vs DGX Spark et re-vérifiés le 4 juillet 2026.
Faits vérifiés. Bande passante et mémoire du DGX Spark (~273 Go/s, 128 Go LPDDR5X, bus 256 bits) : fiche technique DGX Spark / GB10. RTX 5090 (32 Go GDDR7, ~1 792 Go/s, 21 760 cœurs, 575 W) et RTX 5070 (12 Go, ~672 Go/s, 6 144 cœurs) : fiches NVIDIA. Tarif américain du DGX Spark converti à environ 4 323 €, contre 3 679 € avant la hausse de février 2026 rapportée par Tom’s Hardware et VideoCardz ; cette conversion n’est pas un prix TTC européen. Poids GPT-OSS 120B (~65 Go MXFP4, ~80 Go chargé) : model card OpenAI.
Mesures (proxy). Débits GPT-OSS 20B (5090 ≈ 205 tokens/s ; DGX Spark ≈ 50), GPT-OSS 120B sur Spark (≈ 38 tokens/s en llama.cpp, ≈ 50 en SGLang) et Llama 3.1 70B FP8 sur Spark (2,7 tokens/s en decode) : revue LMSYS du 13 octobre 2025 et benchmarks communautaires, détaillés dans le dossier Spark. Mesures faites sous Linux (DGX OS) ; à lire comme des ordres de grandeur.
Estimations crédibles. Prix de rue RTX 5090 UE (3 900 à 4 400 € ; MSRP UE de la Founders Edition 2 099 €) : relevés marchands agrégés du 3 juillet 2026 (bestvaluegpu, VideoCardz), marché en pénurie DRAM. Prix RTX Spark N1X (~2 667 € convertis pour les configurations d’entrée 16-32 Go) : estimations Morgan Stanley, juin 2026, non confirmées par NVIDIA. Consommation DGX Spark : pic système 240 W et SoC GB10 à 140 W de TDP (guide matériel NVIDIA) ; les ~170 W en charge IA sont une observation de presse (StorageReview, forums NVIDIA), variable selon la charge.
Hypothèses assumées. Le plafond de ~4 tokens/s d’un 70 B FP8 dense sur Spark est la division 273 Go/s ÷ 70 Go (plafond de débit, séquence unique) ; la mesure LMSYS correspondante est 2,7 tokens/s, sous le plafond comme attendu (overhead du runtime, trafic du KV cache). Le rapport de débit ~4× entre 5090 et Spark est mesuré sur GPT-OSS 20B ; il varie selon le modèle, le runtime et le batch. Les projections de mémoire future ne constituent pas une mesure des produits actuels.
Conversion de devise. Prix USD convertis au taux indicatif 1 USD = 0,92 EUR (mi-2026).
Crédit image. Photo d’en-tête : KXRORS S300 SFF PC with GeForce RTX 5070 Founders Edition next to NVIDIA DGX Spark par Daniel Lu, CC BY-SA 4.0, via Wikimedia Commons, recadrée.