Le modèle tient, mais vous attendez chaque phrase
Vous utilisez un LLM local pour modifier une fonction ou résumer un document. Le modèle se charge correctement et la mémoire disponible paraît suffisante. Pourtant, le texte se construit lentement, morceau après morceau. Changer de GPU n’est pas la seule piste à examiner.
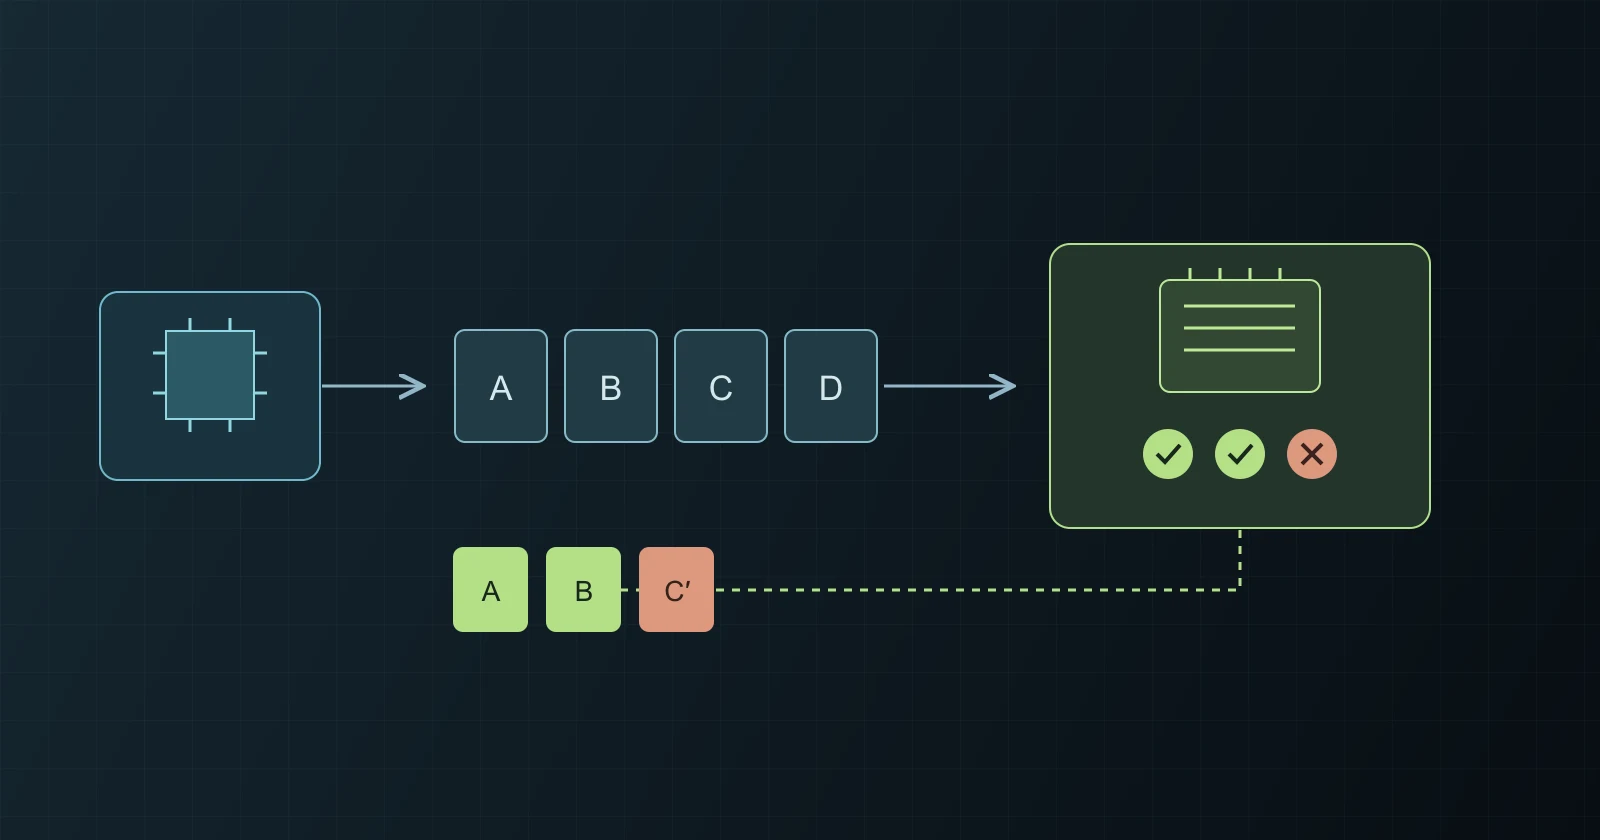
Le décodage spéculatif, ou speculative decoding, essaie de faire avancer cette génération par groupes. Un mécanisme rapide propose plusieurs tokens, les morceaux de texte manipulés par le modèle. Le modèle principal vérifie ces propositions avant qu’elles deviennent la suite de la réponse.
La fonction est documentée dans LM Studio et llama.cpp. Cet article s’appuie sur leurs documents, le code de llama.cpp au 10 septembre 2026 et les travaux scientifiques qui fondent la méthode. Les temps illustratifs ci-dessous sont hypothétiques. LeCompute n’a pas effectué de benchmark d’inférence pour ce dossier.
Proposer vite, puis vérifier plusieurs positions ensemble
Un modèle autorégressif utilise les tokens précédents pour produire le suivant. Sans spéculation, la génération avance donc par étapes dépendantes. Pour proposer quatre nouveaux tokens, le modèle principal doit franchir quatre étapes successives.
Dans le mode classique, un petit modèle auxiliaire, appelé draft model, prépare une proposition. Le principal peut évaluer les positions de cette proposition ensemble : les tokens précédents dont chaque position dépend sont déjà disponibles. Si une proposition est rejetée, le moteur abandonne la suite qui dépend d’elle, corrige cette position et recommence à partir du préfixe validé.
Ce mécanisme est formalisé par Leviathan, Kalman et Matias. Il permet d’amortir une passe du grand modèle sur plusieurs tokens utiles. Il ajoute toutefois le travail du modèle auxiliaire et celui de la vérification : moins de passes successives ne signifie pas automatiquement moins de temps.
L’intérêt est particulièrement clair quand la génération laisse des ressources de calcul disponibles en attendant les données. Une vérification groupée peut mieux exploiter ces ressources. Si le GPU est déjà occupé efficacement par d’autres demandes, le travail supplémentaire change l’équilibre. Le gain sur une conversation ne permet donc pas de prédire celui d’un serveur chargé.
« Sans perte » a une signification précise
Le petit modèle ne remplace pas le principal comme juge de la réponse. Dans l’algorithme exact, la règle d’acceptation tient compte des probabilités des deux modèles et corrige la distribution au premier rejet. Le travail de Chen et ses coauteurs établit aussi cette préservation de la distribution, sous les conditions de l’algorithme.
Cela ne veut pas dire qu’il suffit d’accepter une proposition qui « semble plausible ». Une règle approximative peut changer la distribution. Cela ne garantit pas non plus que deux exécutions avec la même graine produiront exactement le même texte : les opérations numériques et les tirages effectués peuvent différer.
La documentation vLLM sur les garanties sans perte distingue justement la propriété théorique, les tests de l’algorithme et la stabilité numérique. Pour votre essai, conservez le modèle principal, sa quantification et ses paramètres. Accélérer un modèle quantifié ne restaure pas la qualité éventuellement perdue lors de sa quantification.
Le taux d’acceptation ne suffit pas à prédire le gain
Prenons un scénario volontairement simple. Le modèle principal seul demande 40 ms par token. Le petit modèle prépare quatre propositions en 12 ms ; leur vérification prend 52 ms, puis la coordination 4 ms. Un tour spéculatif coûte donc 68 ms. Ces durées sont choisies pour expliquer le calcul, sans référence à une carte particulière.
Si les trois premières propositions sont acceptées et que la quatrième est corrigée, le tour fournit quatre tokens utiles. Le modèle seul aurait demandé 4 × 40 = 160 ms. Le rapport est 160 / 68, soit environ 2,35 fois la vitesse de référence dans ce scénario.
| Propositions acceptées | Tokens utiles | Temps référence | Rapport de vitesse |
|---|---|---|---|
| 0 | 1 | 40 ms | 0,59× : ralentissement |
| 1 | 2 | 80 ms | 1,18× |
| 3 | 4 | 160 ms | 2,35× |
| 4 | 5 | 200 ms | 2,94× |
La formule utile est tokens utiles × temps de référence par token / temps du tour spéculatif. Elle force à compter tout le travail. Dans un essai réel, les durées varient avec le contexte et la taille de proposition. Deux méthodes affichant le même taux d’acceptation peuvent avoir des coûts très différents ; la position du premier rejet compte aussi.
Choisir une paire que le moteur sait faire travailler
Un petit modèle ne convient pas simplement parce qu’il appartient à la même famille commerciale. La tokenisation doit être compatible : un identifiant de token doit représenter le texte attendu. Dans le mode classique, le code de vérification de llama.cpp contrôle notamment le type de vocabulaire, certains tokens spéciaux et la correspondance des entrées.
Des méthodes spécialisées changent ce contrat. EAGLE-3 exploite les états internes du modèle principal et nécessite un auxiliaire préparé pour sa cible. Des méthodes fondées sur les répétitions de tokens peuvent proposer une suite sans charger un deuxième modèle. Ce sont des options différentes, à choisir avec la documentation de la révision utilisée.
Pour un premier essai, une paire explicitement documentée et reconnue par le moteur est préférable à une combinaison improvisée. Dans LM Studio, la documentation cite notamment Qwen 2.5 14B Instruct avec Qwen 2.5 0.5B Instruct. C’est un exemple de paire proposé par l’éditeur, pas une recommandation universelle ni une garantie pour chaque format et backend.
Garder de la place pour le second modèle
Avec un auxiliaire séparé, il faut charger ses poids et les états nécessaires à sa génération. Le KV cache Mémoire des vecteurs clé et valeur déjà calculés pour chaque token traité par un LLM. Évite de recalculer l'attention sur tout l'historique, au prix d'une consommation mémoire qui croît avec le contexte. Approfondir dans le glossaire du principal, qui mémorise les clés et valeurs de l’attention, reste lui aussi présent. Les buffers de vérification et le contexte consomment encore une partie du budget.
Si votre modèle principal occupe presque toute la mémoire GPU, ajouter un auxiliaire peut déplacer des données vers la RAM ou réduire la marge disponible pour le contexte. Une accélération du calcul peut alors être absorbée par des transferts. Commencez par relever les allocations et le placement effectifs, comme dans le guide de dimensionnement VRAM.
La mémoire nécessaire dépend du backend et de la méthode. Un auxiliaire entraîné pour lire les états du principal et une méthode sans second modèle ne se dimensionnent pas comme deux LLM indépendants. Évitez donc une règle unique fondée seulement sur leur nombre de paramètres.
Essayer dans LM Studio ou llama.cpp
Dans LM Studio, chargez d’abord le modèle principal et mesurez quelques tâches représentatives sans auxiliaire. Sélectionnez ensuite un Draft Model dans les réglages de décodage spéculatif, avec une paire compatible. La documentation de la fonction décrit ce parcours et les ralentissements possibles. Le nom des panneaux dépend de la version : les notes de LM Studio 0.4.0 ont réorganisé les anciens modes d’interface. Relevez aussi la version du moteur chargé par l’application.
Avec llama.cpp, les commandes suivantes correspondent aux options documentées dans la révision 72797e89198a. target.gguf et draft.gguf sont des noms à remplacer par vos fichiers compatibles. Le contexte de 8 192 tokens et la proposition de quatre tokens sont des points de départ pour l’essai, pas des valeurs optimales.
llama-server --model target.gguf --ctx-size 8192 --parallel 1 --host 127.0.0.1 --port 8080 --spec-type noneArrêtez ce serveur après la mesure, puis lancez le second dans les mêmes conditions. Les deux commandes laissent le placement matériel aux réglages du moteur : vérifiez ses journaux pour savoir quelles couches sont effectivement exécutées sur le GPU.
llama-server --model target.gguf --model-draft draft.gguf --ctx-size 8192 --parallel 1 --host 127.0.0.1 --port 8080 --spec-type draft-simple --spec-draft-n-max 4Les anciennes options --draft ou --draft-max sont signalées comme retirées dans le README du serveur à cette révision. Contrôlez llama-server --help si vous utilisez un autre binaire. Une option acceptée ne prouve pas à elle seule que la spéculation est active : cherchez aussi les statistiques de propositions et d’acceptation.
Comparer le travail terminé, pas le meilleur compteur
Le client de mesure à télécharger utilise uniquement la bibliothèque standard de Python et l’endpoint natif /completion de llama.cpp. Il rejoue trois prompts, effectue un échauffement puis cinq passages, désactive la réutilisation du préfixe entre demandes et écrit un JSON. Il conserve le temps total vu par le client, les timings du serveur et les sorties, pour pouvoir examiner les écarts. Il ne mesure pas le premier token en streaming ni la mémoire GPU.
python speculative-benchmark.py --label baseline --output baseline.json
python speculative-benchmark.py --label draft --output draft.json
Exécutez la première commande pendant que le serveur de référence tourne, la seconde après son remplacement. Le client emploie un échantillonnage glouton, qui choisit le token le plus probable, pour faciliter la comparaison. Ses prompts sont envoyés bruts, sans gabarit de conversation : pour évaluer un assistant, reproduisez ensuite le format de dialogue attendu par votre modèle dans les deux configurations. Ajoutez vos vrais prompts et vos paramètres usuels dans cette expérience séparée. La limite de sortie du script peut rendre certaines réponses incomplètes : contrôlez leur longueur et leur contenu avant d’interpréter les temps.
Comparez chaque tâche avec elle-même, regardez la médiane et la dispersion, puis vérifiez les sorties. Si les réponses diffèrent sensiblement en longueur ou ne terminent pas le même travail, le ratio de temps ne représente plus une accélération à travail égal. Pour un agent, mesurez aussi le temps avant la première sortie, les appels d’outils et la réussite de la tâche complète.
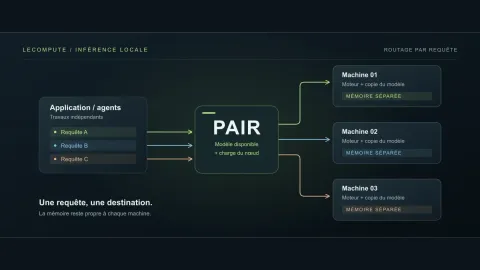
Gardez la configuration spéculative si elle améliore vos tâches avec une marge mémoire acceptable. Si elle ralentit ou n’apporte rien, ce résultat aide à choisir un auxiliaire plus léger, une autre longueur de proposition ou simplement à conserver le modèle seul. Pour plusieurs machines exécutant des demandes indépendantes, NVIDIA PAIR traite un autre problème : la répartition des requêtes, plutôt que l’accélération d’une même génération.
Sources et méthode
Fondements. Yaniv Leviathan, Matan Kalman et Yossi Matias, Fast Inference from Transformers via Speculative Decoding, version du 18 mai 2023 ; Charlie Chen et coauteurs, Accelerating Large Language Model Decoding with Speculative Sampling, 2023. Leurs démonstrations portent sur les algorithmes décrits, sans garantir toutes les variantes logicielles.
Implémentations examinées. llama.cpp, commit 72797e89198ab564fd0e6baa54ab196e8dd1d884 du 10 septembre 2026 : documentation des méthodes, code de compatibilité et options du serveur liés dans le texte. LM Studio, décodage spéculatif et évolution de l’interface. vLLM, garanties sans perte. Consultation le 10 septembre 2026. Les versions embarquées par une application peuvent différer du dépôt amont.
Calculs et vérification. Les durées et ratios du tableau sont des hypothèses pédagogiques calculées, sans matériel associé. Les commandes ont été confrontées aux options du code cité ; elles n’ont pas servi à un benchmark matériel LeCompute. Le client Python est un outil de reproduction, dont la logique peut être vérifiée sans modèle. Ses résultats doivent provenir de votre serveur, pas des valeurs illustratives de cet article.